特斯拉發表電動卡車 Cybertruck,一台從科幻電影走出來的鋼鐵車

今天的 Elon Musk 看起來不像鋼鐵人,更像蝙蝠俠,因為他們的新車 Cybertruck,不但外型酷似蝙蝠車,同時還能防彈防撞,並且擁有超越保時捷的加速度,跟勝過市面上卡車的拖吊能力,更驚人的是,售價只要 39,900 美元起。

眾所期待的特斯拉新車 Cybertruck 今日正式發表,和之前流出的影像不同,Cybertruck 酷似隱形戰機 F-117 的設計,讓人聯想到蝙蝠車,甚至懷疑這是不是一台防雷達偵測的戰車?

Tesla Cybertruck 全車採用冷鑄鋼板,能夠抵擋 9mm 口徑手槍的射擊,現場展示用重鎚敲擊也毫髮無傷;車窗玻璃同樣採用防彈設計,然而有趣的是,現場展示時,被大鐵球砸出了一片雪花。「至少,它沒被打穿,你坐在裡面很安全。」Elon Musk 笑著說。

Cybertruck 為了因應負重,搭載了適應性氣壓懸吊系統,針對高速公路,或是越野泥巴路,能夠自動調整懸吊高度,同時也順便使用這個氣壓系統,做了一個高壓出力裝置,使用者可以自行加裝不同氣壓工具,像是高壓水槍或是電鑽等。

當重裝電動機車開上後廂時,懸吊系統會自動調整車尾高度,讓車身保持平衡。

車尾與其他皮卡車開放式貨斗不同,Cybertruck 採用封閉式貨斗,並有升降式尾門,現場展示時,將這台電動機車 ATV 直接騎上貨斗後,還能直接充電,顯然是在致敬蝙蝠車跟蝙蝠機車。

Cybertruck 如同其他皮卡車,車尾裝有釣鉤,能夠充當拖車使用,而歸功於它的強力馬達,拖車能力屌打了皮卡車霸主 Ford F-150,在現場展示的影片中,特斯拉讓 Cybertruck 跟 F-150 互相拖住對方,進行拔河測試,結果 F-150 整台被 Cybertruck 拖走。

F-150 慘遭 Cybertruck 拖走。

馬斯克強調,一般皮卡車需要另外裝載發電機才能使用電動工具,Cybertruck 直接提供了電源,因此省下不少空間,同時還提供強大的拖力。

此外,做為一台卡車,Cybertruck 莫名其妙地擁有超越保時捷的加速度,根據現場公布數據,最頂級版的 0-100 公里加速時間不到 3 秒。現場展示了 Cybertruck 與 Porsche 911 賽跑的影片,起步雖然小輸一點,但隨後就超越了 911。

現場展示競速影片,大約 1 秒後,Cybertruck 就超過了 911。

Tesla Cybertruck 共有 3 種版本,依照馬達數量來分別,最低價 39,900 美元起,最高 69,900 美元。Cybertruck 從今天起在美國開放預購,實際交車時間預計要等到 2021 年底。頂級的三馬達款,更預計要等到 2022 年底才會開始生產。

如同馬斯克開場所說,卡車在過去幾十年來都長得差不多,特斯拉要打造一台完全不一樣的卡車,同時還要保持零排放,跟超高性能,從今天的現場展示來看,特斯拉再次完成一個不可能的任務。在興奮之餘也別忘了,這一切都是現場展示,實際上如何,就有待實際交車後驗證了!

(合作媒體:。圖片來源:)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※公開收購3c價格,不怕被賤賣!

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象
【其他文章推薦】

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※公開收購3c價格,不怕被賤賣!

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

[apue] 神奇的 Solaris pipe

說到 pipe 大家可能都不陌生,經典的pipe調用配合fork進行父子進程通訊,簡直就是Unix程序的標配。

然而Solaris上的pipe卻和Solaris一樣是個奇葩(雖然Solaris前途黯淡,但是不妨礙我們從它裏面挖掘一些有價值的東西),

有着和一般pipe諸多的不同之處,本文就來說說Solaris上神奇的pipe和一般pipe之間的異同。


1.solaris pipe 是全雙工的

一般系統上的pipe調用是半雙工的,只能單向傳遞數據,如果需要雙向通訊,我們一般是建兩個pipe分別讀寫。像下面這樣:

 1     int n, fd1[2], fd2[2]; 
 2     if (pipe (fd1) < 0 || pipe(fd2) < 0)
 3         err_sys ("pipe error"); 
 4 
 5     char line[MAXLINE]; 
 6     pid_t pid = fork (); 
 7     if (pid < 0) 
 8         err_sys ("fork error"); 
 9     else if (pid > 0)
10     {
11         close (fd1[0]);  // write on pipe1 as stdin for co-process
12         close (fd2[1]);  // read on pipe2 as stdout for co-process
13         while (fgets (line, MAXLINE, stdin) != NULL) { 
14             n = strlen (line); 
15             if (write (fd1[1], line, n) != n)
16                 err_sys ("write error to pipe"); 
17             if ((n = read (fd2[0], line, MAXLINE)) < 0)
18                 err_sys ("read error from pipe"); 
19 
20             if (n == 0) { 
21                 err_msg ("child closed pipe"); 
22                 break;
23             }
24             line[n] = 0; 
25             if (fputs (line, stdout) == EOF)
26                 err_sys ("fputs error"); 
27         }
28 
29         if (ferror (stdin))
30             err_sys ("fputs error"); 
31 
32         return 0; 
33     }
34     else { 
35         close (fd1[1]); 
36         close (fd2[0]); 
37         if (fd1[0] != STDIN_FILENO) { 
38             if (dup2 (fd1[0], STDIN_FILENO) != STDIN_FILENO)
39                 err_sys ("dup2 error to stdin"); 
40             close (fd1[0]); 
41         }
42 
43         if (fd2[1] != STDOUT_FILENO) { 
44             if (dup2 (fd2[1], STDOUT_FILENO) != STDOUT_FILENO)
45                 err_sys ("dup2 error to stdout"); 
46             close (fd2[1]); 
47         }
48 
49         if (execl (argv[1], "add2", (char *)0) < 0)
50             err_sys ("execl error"); 
51     }

這個程序創建兩個管道,fd1用來寫請求,fd2用來讀應答;對子進程而言,fd1重定向到標準輸入,fd2重定向到標準輸出,讀取stdin中的數據相加然後寫入stdout完成工作。父進程在取得應答後向標準輸出寫入結果。

如果在Solaris上,可以直接用一個pipe同時讀寫,代碼可以重寫成這樣:

 1 int fd[2];
 2 if (pipe(fd) < 0) 
 3     err_sys("pipe error\n");
 4 
 5 char line[MAXLINE];
 6 pid_t pid = fork();
 7 if (pid < 0)
 8     err_sys("fork error\n");
 9 else if (pid > 0)
10 {
11     close(fd[1]);
12     while (fgets(line, MAXLINE, stdin) != NULL) {
13         n = strlen(line);
14         if (write(fd[0], line, n) != n)
15             err_sys("write error to pipe\n")
16         if ((n = read(fd[0], line, MAXLINE)) < 0) 
17             err_sys("read error from pipe\n");
18 
19         if (n == 0) 
20             err_sys("child closed pipe\n");
21         line[n] = 0;
22         if (fputs(line, stdout) == EOF) 
23             err_sys("fputs error\n");
24     }
25 
26     if (ferror(stdin))
27         err_sys("fputs error\n");
28 
29     return 0;
30 }
31 else {
32     close(fd[0]);
33     if (fd[1] != STDIN_FILENO)
34         if (dup2(fd[1], STDIN_FILENO) != STDIN_FILENO)
35             err_sys("dup2 error to stdin\n");
36 
37     if (fd[1] != STDOUT_FILENO) {
38         if (dup2(fd[1], STDOUT_FILENO) != STDOUT_FILENO)
39             err_sys("dup2 error to stdout\n");
40         close(fd[1]);
41     }
42 
43     if (execl(argv[1], argv[2], (char *)0) < 0)
44         err_sys("execl error\n");
45 
46 }

代碼清爽多了,不用去考慮fd1[0]和fd2[1]是啥意思是一件很養腦的事。

不過這樣的代碼只能在Solaris上運行(聽說BSD也支持?),如果考慮到可移植性,還是寫上面的比較穩妥。


測試程序


2. solaris pipe 可以脫離父子關係建立

pipe 好用但是沒法脫離fork使用,一般的pipe如果想讓任意兩個進程通訊,得藉助它的變身fifo來實現。

關於FIFO,詳情可參考我之前寫的一篇文章:


而Solaris上的pipe沒這麼多事,加入兩個調用:fattach / fdetach,你就可以像使用FIFO一樣使用pipe了:

 1 int fd[2];
 2 if (pipe(fd) < 0)
 3     err_sys("pipe error\n");
 4 
 5 if (fattach(fd[1], "./pipe") < 0)
 6     err_sys("fattach error\n");
 7 
 8 printf("attach to file pipe ok\n");
 9 
10 close(fd[1]);
11 char line[MAXLINE];
12 while (fgets(line, MAXLINE, stdin) != NULL) {
13     n = strlen(line);
14     if (write(fd[0], line, n) != n)
15         err_sys("write error to pipe\n");
16     if ((n = read(fd[0], line, MAXLINE)) < 0)
17         err_sys("read error from pipe\n");
18 
19     if (n == 0) 
20         err_sys("child closed pipe\n");
21 
22     line[n] = 0;
23     if (fputs(line, stdout) == EOF)
24         err_sys("fputs error\n");
25 }
26 
27 if (ferror(stdin))
28     err_sys("fputs error\n");
29 
30 if (fdetach("./pipe") < 0)
31     err_sys("fdetach error\n");
32 
33 printf("detach from file pipe ok\n");

在pipe調用之後立即加入fattach調用,可以將管道關聯到文件系統的一個文件名上,該文件必需事先存在,且可讀可寫。

在fattach調用之前這個文件(./pipe)是個普通文件,打開讀寫都是磁盤IO;

在fattach調用之後,這個文件就變身成為一個管道了,打開讀寫都是內存流操作,且管道的另一端就是attach的那個進程。

子進程也需要改造一下,以便使用pipe通訊:

 1 int fd, n, int1, int2;
 2 char line[MAXLINE];
 3 fd = open("./pipe", O_RDWR);
 4 if (fd < 0)
 5     err_sys("open file pipe failed\n");
 6 
 7 printf("open file pipe ok, fd = %d\n", fd);
 8 while ((n = read(fd, line, MAXLINE)) > 0) {
 9     line[n] = 0;
10     if (sscanf(line, "%d%d", &int1, &int2) == 2) {
11         sprintf(line, "%d\n", int1 + int2);
12         n = strlen(line);
13         if (write(fd, line, n) != n)
14             err_sys("write error\n");
15 
16         printf("i am working on %s\n", line);
17     }
18     else {
19         if (write(fd, "invalid args\n", 13) != 13)
20             err_sys("write msg error\n");
21     }
22 }
23 
24 close(fd);

打開pipe就如同打開普通文件一樣,open直接搞定。當然前提是attach進程必需已經在運行。

當attach進程detach后,管道文件又將恢復它的本來面目。


脫離了父子關係的pipe其實可以建立多對一關係(多對多關係不可以,因為只能有一個進程attach)。

例如開4個cmd窗口,分別執行以下命令:

./padd2 abc
./add2
./add2
./add2

 向attach進程(padd2)發送9個計算請求后,可以看到輸出結果如下:

-bash-3.2$ ./padd2 abc
attach to file pipe ok
1 1
2
2 2
4
3 3 
6
4 4
8
5 5
10
6 6 
12
7 7 
14
8 8
16
9 9
18

 再回來看各個open管道的進程,輸出分別如下:

-bash-3.2$ ./add2
open file pipe ok, fd = 3
source: 1 1
i am working on 2
source: 4 4
i am working on 8
source: 7 7 
i am working on 14 


-bash-3.2$ ./add2
open file pipe ok, fd = 3
source: 2 2
i am working on 4
source: 5 5
i am working on 10
source: 9 9
i am working on 18 


-bash-3.2$ ./add2
open file pipe ok, fd = 3
source: 2 2
i am working on 4
source: 5 5
i am working on 10
source: 9 9
i am working on 18 


-bash-3.2$ ./add2
open file pipe ok, fd = 3
source: 3 3
i am working on 6
source: 6 6
i am working on 12
source: 8 8 
i am working on 16


可以發現一個很有趣的現象,就是各個add2進程基本是輪着來獲取請求的,可以猜想底層的pipe可能有一個進程排隊機制。

但是反過來使用pipe就不行了。就是說當啟動一個add3(區別於上例的add2與padd2)作為fattach端打開pipe,啟動多個padd3作為open端使用pipe,

然後通過命令行給padd3傳遞要相加的值,可以寫一個腳本同時啟動多個padd3,來查看效果:

#! /bin/sh
./padd3 1 1 &
./padd3 2 2 &
./padd3 3 3 &
./padd3 4 4 &

 這個腳本中啟動了4個加法進程,同時向add3發送4個加法請求,腳本中四個進程輸出如下:

-bash-3.2$ ./padd3.sh
-bash-3.2$ open file pipe ok, fd = 3
1 1 = 2
open file pipe ok, fd = 3
2 2 = 4
open file pipe ok, fd = 3
4 4 = 37

 可以看到3+3的請求被忽略了,轉到add3查看輸出:

-bash-3.2$ ./add3
attach to file pipe ok
source: 1 1
i am working on 1 + 1 = 2
source: 2 2
i am working on 2 + 2 = 4
source: 3 34 4
i am working on 3 + 34 = 37

 原來是3+3與4+4兩個請求粘連了,導致add3識別成一個3+34的請求,所以出錯了。

多運行幾遍腳本后,發現還有這樣的輸出:

-bash-3.2$ ./padd3.sh
-bash-3.2$ open file pipe ok, fd = 3
4 4 = 2
open file pipe ok, fd = 3
2 2 = 4
open file pipe ok, fd = 3
3 3 = 6
open file pipe ok, fd = 3
1 1 = 8

  4+4=2?1+1=8?再看add3這頭的輸出:

-bash-3.2$ ./add3
attach to file pipe ok
source: 1 1
i am working on 1 + 1 = 2
source: 2 2
i am working on 2 + 2 = 4
source: 3 3
i am working on 3 + 3 = 6
source: 4 4
i am working on 4 + 4 = 8

 完全正常呢。

經過一番推理,發現是4+4的請求取得了1+1請求的應答;1+1的請求取得了4+4的應答。

可見這樣的結構還有一個弊端,同時請求的進程可能無法得到自己的應答,應答與請求之間相互錯位。

所以想用fattach來實現多路請求的人還是洗洗睡吧,畢竟它就是一個pipe不是,還能給它整成tcp么?

而之前的例子可以,是因為請求是順序發送的,上個請求得到應答后才發送下個請求,所以不存在這個例子的問題(但是實用性也不高)。


測試程序


3. solaris pipe 可以通過connld模塊實現類似tcp的多路連接

第2條剛說不能實現多路連接,第3條就接着來打臉了,這是由於Solaris上的pipe都是基於STREAMS技術構建,

而STREAMS是支持靈活的PUSH、POP流處理模塊的,再加上STREAMS傳遞文件fd的能力,就可以支持類似tcp中accept的能力。

即每個open pipe文件的進程,得到的不是原來管道的fd,而是新創建管道的fd,而管道的另一側fd則通過已有的管道發送到attach進程,

後者使用這個新的fd與客戶進程通訊。為了支持多路連接,我們的代碼需要重新整理一下,首先看客戶端:

1 int fd;
2 char line[MAXLINE];
3 fd = cli_conn("./pipe");
4 if (fd < 0)
5     return 0;

這裏將open相關邏輯封裝到了cli_conn函數中,以便之後復用:

 1 int cli_conn(const char *name)
 2 {
 3     int fd;
 4     if ((fd = open(name, O_RDWR)) < 0) {
 5         printf("open pipe file failed\n");
 6         return -1;
 7     }
 8 
 9     if (isastream(fd) == 0) {
10         close(fd);
11         return -2;
12     }
13 
14     return fd;
15 }

可以看到與之前幾乎沒有變化,只是增加了isastream調用防止attach進程沒有啟動。

再來看下服務端:

 1 int listenfd = serv_listen("./pipe");
 2 if (listenfd < 0)
 3     return 0;
 4 
 5 int acceptfd = 0;
 6 int n = 0, int1 = 0, int2 = 0;
 7 char line[MAXLINE];
 8 uid_t uid = 0;
 9 while ((acceptfd = serv_accept(listenfd, &uid)) >= 0)
10 {
11     printf("accept a client, fd = %d, uid = %ld\n", acceptfd, uid);
12     while ((n = read(acceptfd, line, MAXLINE)) > 0) {
13         line[n] = 0;
14         printf("source: %s\n", line);
15         if (sscanf(line, "%d%d", &int1, &int2) == 2) {
16             sprintf(line, "%d\n", int1 + int2);
17             n = strlen(line);
18             if (write(acceptfd, line, n) != n) {
19                 printf("write error\n");
20                 return 0;
21             }
22             printf("i am working on %d + %d = %s\n", int1, int2, line);
23         }
24         else {
25             if (write(acceptfd, "invalid args\n", 13) != 13) {
26                 printf("write msg error\n");
27                 return 0;
28             }
29         }
30     }
31 
32     close(acceptfd);
33 }
34 
35 if (fdetach("./pipe") < 0) {
36     printf("fdetach error\n");
37     return 0;
38 }
39 
40 printf("detach from file pipe ok\n");
41 close(listenfd);

首先調用serv_listen建立基本pipe,然後不斷在該pipe上調用serv_accept來獲取獨立的客戶端連接。之後的邏輯與以前一樣。

現在重點看下封裝的這兩個方法:

 1 int serv_listen(const char *name)
 2 {
 3     int tempfd;
 4     int fd[2];
 5     unlink(name);
 6     tempfd = creat(name, FIFO_MODE);
 7     if (tempfd < 0) {
 8         printf("creat failed\n");
 9         return -1;
10     }
11 
12     if (close(tempfd) < 0) {
13         printf("close temp fd failed\n");
14         return -2;
15     }
16 
17     if (pipe(fd) < 0) {
18         printf("pipe error\n");
19         return -3;
20     }
21 
22     if (ioctl(fd[1], I_PUSH, "connld") < 0) {
23         printf("I_PUSH connld failed\n");
24         close(fd[0]);
25         close(fd[1]);
26         return -4;
27     }
28 
29     printf("push connld ok\n");
30     if (fattach(fd[1], name) < 0) {
31         printf("fattach error\n");
32         close(fd[0]);
33         close(fd[1]);
34         return -5;
35     }
36 
37     printf("attach to file pipe ok\n");
38     close(fd[1]);
39     return fd[0];
40 }

serv_listen封裝了與建立基本pipe相關的代碼,首先確保pipe文件存在且可讀寫,然後創建普通的pipe,在fattach調用之前必需先PUSH一個connld模塊到該pipe STREAM中。這樣就大功告成!

 1 int serv_accept(int listenfd, uid_t *uidptr)
 2 {
 3     struct strrecvfd recvfd;
 4     if (ioctl(listenfd, I_RECVFD, &recvfd) < 0) {
 5         printf("I_RECVFD from listen fd failed\n");
 6         return -1;
 7     }
 8 
 9     if (uidptr)
10         *uidptr = recvfd.uid;
11 
12     return recvfd.fd;
13 }

當有客戶端連接上來的時候,使用I_RECVFD接收connld返回的另一個pipe的fd。之後的數據將在該pipe進行。

看了看,感覺和tcp的listen與accept別無二致,看來天下武功,至精深處都是英雄所見略同。

之前的多個客戶端同時運行的例子再跑一遍,觀察attach端輸出:

-bash-3.2$ ./add4
push connld ok
attach to file pipe ok
accept a client, fd = 4, uid = 101
source: 1 1
i am working on 1 + 1 = 2
accept a client, fd = 4, uid = 101
source: 2 2
i am working on 2 + 2 = 4
accept a client, fd = 4, uid = 101
source: 3 3
i am working on 3 + 3 = 6
accept a client, fd = 4, uid = 101
source: 4 4
i am working on 4 + 4 = 8

 一切正常。再看下腳本中四個進程的輸出:

-bash-3.2$ ./padd4.sh
-bash-3.2$ open file pipe ok, fd = 3
1 1 = 2
open file pipe ok, fd = 3
2 2 = 4
open file pipe ok, fd = 3
3 3 = 6
open file pipe ok, fd = 3
4 4 = 8

 也是沒問題的,既沒有出現多個請求粘連的情況,也沒有出現請求與應答錯位的情況。


測試程序


4.結論

Solaris 上的pipe不僅可以全雙工通訊、不依賴父子進程關係,還可以實現類似tcp那樣分離多個客戶端通訊連接的能力。

雖然Solaris前途未卜,但是希望一些好的東西還是能流傳下來,就比如這個神奇的pipe。


看完今天的文章,你是不是對特立獨行的Solaris又加深了一層了解?歡迎留言區說說你認識的Solaris。


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※公開收購3c價格,不怕被賤賣!

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

[ch02-03] 梯度下降

系列博客,原文在筆者所維護的github上:,
點擊star加星不要吝嗇,星越多筆者越努力。

2.3 梯度下降

2.3.1 從自然現象中理解梯度下降

在大多數文章中,都以“一個人被困在山上,需要迅速下到谷底”來舉例,這個人會“尋找當前所處位置最陡峭的地方向下走”。這個例子中忽略了安全因素,這個人不可能沿着最陡峭的方向走,要考慮坡度。

在自然界中,梯度下降的最好例子,就是泉水下山的過程:

  1. 水受重力影響,會在當前位置,沿着最陡峭的方向流動,有時會形成瀑布(梯度下降);
  2. 水流下山的路徑不是唯一的,在同一個地點,有可能有多個位置具有同樣的陡峭程度,而造成了分流(可以得到多個解);
  3. 遇到坑窪地區,有可能形成湖泊,而終止下山過程(不能得到全局最優解,而是局部最優解)。

2.3.2 梯度下降的數學理解

梯度下降的數學公式:

\[\theta_{n+1} = \theta_{n} – \eta \cdot \nabla J(\theta) \tag{1}\]

其中:

  • \(\theta_{n+1}\):下一個值;
  • \(\theta_n\):當前值;
  • \(-\):減號,梯度的反向;
  • \(\eta\):學習率或步長,控制每一步走的距離,不要太快以免錯過了最佳景點,不要太慢以免時間太長;
  • \(\nabla\):梯度,函數當前位置的最快上升點;
  • \(J(\theta)\):函數。

梯度下降的三要素

  1. 當前點;
  2. 方向;
  3. 步長。

為什麼說是“梯度下降”?

“梯度下降”包含了兩層含義:

  1. 梯度:函數當前位置的最快上升點;
  2. 下降:與導數相反的方向,用數學語言描述就是那個減號。

亦即與上升相反的方向運動,就是下降。

圖2-9 梯度下降的步驟

圖2-9解釋了在函數極值點的兩側做梯度下降的計算過程,梯度下降的目的就是使得x值向極值點逼近。

2.3.3 單變量函數的梯度下降

假設一個單變量函數:

\[J(x) = x ^2\]

我們的目的是找到該函數的最小值,於是計算其微分:

\[J'(x) = 2x\]

假設初始位置為:

\[x_0=1.2\]

假設學習率:

\[\eta = 0.3\]

根據公式(1),迭代公式:

\[x_{n+1} = x_{n} – \eta \cdot \nabla J(x)= x_{n} – \eta \cdot 2x\tag{1}\]

假設終止條件為J(x)<1e-2,迭代過程是:

x=0.480000, y=0.230400
x=0.192000, y=0.036864
x=0.076800, y=0.005898
x=0.030720, y=0.000944

上面的過程如圖2-10所示。

圖2-10 使用梯度下降法迭代的過程

2.3.4 雙變量的梯度下降

假設一個雙變量函數:

\[J(x,y) = x^2 + \sin^2(y)\]

我們的目的是找到該函數的最小值,於是計算其微分:

\[{\partial{J(x,y)} \over \partial{x}} = 2x\]
\[{\partial{J(x,y)} \over \partial{y}} = 2 \sin y \cos y\]

假設初始位置為:

\[(x_0,y_0)=(3,1)\]

假設學習率:

\[\eta = 0.1\]

根據公式(1),迭代過程是的計算公式:
\[(x_{n+1},y_{n+1}) = (x_n,y_n) – \eta \cdot \nabla J(x,y)\]
\[ = (x_n,y_n) – \eta \cdot (2x,2 \cdot \sin y \cdot \cos y) \tag{1}\]

根據公式(1),假設終止條件為\(J(x,y)<1e-2\),迭代過程如表2-3所示。

表2-3 雙變量梯度下降的迭代過程

迭代次數 x y J(x,y)
1 3 1 9.708073
2 2.4 0.909070 6.382415
… … … …
15 0.105553 0.063481 0.015166
16 0.084442 0.050819 0.009711

迭代16次后,J(x,y)的值為0.009711,滿足小於1e-2的條件,停止迭代。

上面的過程如表2-4所示,由於是雙變量,所以需要用三維圖來解釋。請注意看兩張圖中間那條隱隱的黑色線,表示梯度下降的過程,從紅色的高地一直沿着坡度向下走,直到藍色的窪地。

表2-4 在三維空間內的梯度下降過程

觀察角度1 觀察角度2

2.3.5 學習率η的選擇

在公式表達時,學習率被表示為\(\eta\)。在代碼里,我們把學習率定義為learning_rate,或者eta。針對上面的例子,試驗不同的學習率對迭代情況的影響,如表2-5所示。

表2-5 不同學習率對迭代情況的影響

學習率 迭代路線圖 說明
1.0 學習率太大,迭代的情況很糟糕,在一條水平線上跳來跳去,永遠也不能下降。
0.8 學習率大,會有這種左右跳躍的情況發生,這不利於神經網絡的訓練。
0.4 學習率合適,損失值會從單側下降,4步以後基本接近了理想值。
0.1 學習率較小,損失值會從單側下降,但下降速度非常慢,10步了還沒有到達理想狀態。

代碼位置

ch02, Level3, Level4, Level5

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※公開收購3c價格,不怕被賤賣!

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

18個awk的經典實戰案例

介紹

這些案例是我收集起來的,大多都是我自己遇到過的,有些比較經典,有些比較具有代表性。

這些awk案例我也錄了相關視頻的講解,歡迎大家去瞅瞅。

插入幾個新字段

在”abc d”的b後面插入3個字段e f g。

echo a b c d|awk '{$3="e f g "$3}1'

格式化空白

移除每行的前綴、後綴空白,並將各部分左對齊。

      aaaa        bbb     ccc                 
   bbb     aaa ccc
ddd       fff             eee gg hh ii jj
awk 'BEGIN{OFS="\t"}{$1=$1;print}' a.txt

執行結果:

aaaa    bbb     ccc
bbb     aaa     ccc
ddd     fff     eee     gg      hh      ii      jj

篩選IPv4地址

從ifconfig命令的結果中篩選出除了lo網卡外的所有IPv4地址。

讀取.ini配置文件中的某段

[base]
name=os_repo
baseurl=https://xxx/centos/$releasever/os/$basearch
gpgcheck=0

enable=1

[mysql]
name=mysql_repo
baseurl=https://xxx/mysql-repo/yum/mysql-5.7-community/el/$releasever/$basearch

gpgcheck=0
enable=1

[epel]
name=epel_repo
baseurl=https://xxx/epel/$releasever/$basearch
gpgcheck=0
enable=1
[percona]
name=percona_repo
baseurl = https://xxx/percona/release/$releasever/RPMS/$basearch
enabled = 1
gpgcheck = 0

根據某字段去重

去掉uid=xxx重複的行。

2019-01-13_12:00_index?uid=123
2019-01-13_13:00_index?uid=123
2019-01-13_14:00_index?uid=333
2019-01-13_15:00_index?uid=9710
2019-01-14_12:00_index?uid=123
2019-01-14_13:00_index?uid=123
2019-01-15_14:00_index?uid=333
2019-01-16_15:00_index?uid=9710
awk -F"?" '!arr[$2]++{print}' a.txt

結果:

2019-01-13_12:00_index?uid=123
2019-01-13_14:00_index?uid=333
2019-01-13_15:00_index?uid=9710

次數統計

portmapper
portmapper
portmapper
portmapper
portmapper
portmapper
status
status
mountd
mountd
mountd
mountd
mountd
mountd
nfs
nfs
nfs_acl
nfs
nfs
nfs_acl
nlockmgr
nlockmgr
nlockmgr
nlockmgr
nlockmgr
awk '{arr[$1]++}END{OFS="\t";for(idx in arr){printf arr[idx],idx}}' a.txt

統計TCP連接狀態數量

$ netstat -tnap
Proto Recv-Q Send-Q Local Address   Foreign Address  State       PID/Program name
tcp        0      0 0.0.0.0:22      0.0.0.0:*        LISTEN      1139/sshd
tcp        0      0 127.0.0.1:25    0.0.0.0:*        LISTEN      2285/master
tcp        0     96 192.168.2.17:22 192.168.2.1:2468 ESTABLISHED 87463/sshd: root@pt
tcp        0      0 192.168.2017:22 192.168.201:5821 ESTABLISHED 89359/sshd: root@no
tcp6       0      0 :::3306         :::*             LISTEN      2289/mysqld
tcp6       0      0 :::22           :::*             LISTEN      1139/sshd
tcp6       0      0 ::1:25          :::*             LISTEN      2285/master

統計得到的結果:

5: LISTEN
2: ESTABLISHED

一行式:

netstat -tna | awk '/^tcp/{arr[$6]++}END{for(state in arr){print arr[state] ": " state}}'
netstat -tna | /usr/bin/grep 'tcp' | awk '{print $6}' | sort | uniq -c

統計日誌中各IP訪問非200狀態碼的次數

日誌示例數據:

111.202.100.141 - - [2019-11-07T03:11:02+08:00] "GET /robots.txt HTTP/1.1" 301 169 

統計非200狀態碼的IP,並取次數最多的前10個IP。

# 法一
awk '$8!=200{arr[$1]++}END{for(i in arr){print arr[i],i}}' access.log | sort -k1nr | head -n 10

# 法二:
awk '
    $8!=200{arr[$1]++}
    END{
        PROCINFO["sorted_in"]="@val_num_desc";
        for(i in arr){
            if(cnt++==10){exit}
            print arr[i],i
        }
}' access.log

統計獨立IP

​ url 訪問IP 訪問時間訪問人

a.com.cn|202.109.134.23|2015-11-20 20:34:43|guest
b.com.cn|202.109.134.23|2015-11-20 20:34:48|guest
c.com.cn|202.109.134.24|2015-11-20 20:34:48|guest
a.com.cn|202.109.134.23|2015-11-20 20:34:43|guest
a.com.cn|202.109.134.24|2015-11-20 20:34:43|guest
b.com.cn|202.109.134.25|2015-11-20 20:34:48|guest

需求:統計每個URL的獨立訪問IP有多少個(去重),並且要為每個URL保存一個對應的文件,得到的結果類似:

a.com.cn  2
b.com.cn  2
c.com.cn  1

並且有三個對應的文件:

a.com.cn.txt
b.com.cn.txt
c.com.cn.txt

代碼:

處理字段缺失的數據

ID  name    gender  age  email          phone
1   Bob     male    28   abc@qq.com     18023394012
2   Alice   female  24   def@gmail.com  18084925203
3   Tony    male    21                  17048792503
4   Kevin   male    21   bbb@189.com    17023929033
5   Alex    male    18   ccc@xyz.com    18185904230
6   Andy    female       ddd@139.com    18923902352
7   Jerry   female  25   exdsa@189.com  18785234906
8   Peter   male    20   bax@qq.com     17729348758
9   Steven          23   bc@sohu.com    15947893212
10  Bruce   female  27   bcbd@139.com   13942943905

當字段缺失時,直接使用FS劃分字段來處理會非常棘手。gawk為了解決這種特殊需求,提供了FIELDWIDTHS變量。

FIELDWIDTH可以按照字符數量劃分字段。

awk '{print $4}' FIELDWIDTHS="2 2:6 2:6 2:3 2:13 2:11" a.txt

處理字段中包含了字段分隔符的數據

下面是CSV文件中的一行,該CSV文件以逗號分隔各個字段。

Robbins,Arnold,"1234 A Pretty Street, NE",MyTown,MyState,12345-6789,USA

需求:取得第三個字段”1234 A Pretty Street, NE”。

當字段中包含了字段分隔符時,直接使用FS劃分字段來處理會非常棘手。gawk為了解決這種特殊需求,提供了FPAT變量。

FPAT可以收集正則匹配的結果,並將它們保存在各個字段中。(就像grep匹配成功的部分會加顏色顯示,而使用FPAT劃分字段,則是將匹配成功的部分保存在字段$1 $2 $3...中)。

echo 'Robbins,Arnold,"1234 A Pretty Street, NE",MyTown,MyState,12345-6789,USA' |\
awk 'BEGIN{FPAT="[^,]+|\".*\""}{print $1,$3}'

取字段中指定字符數量

16  001agdcdafasd
16  002agdcxxxxxx
23  001adfadfahoh
23  001fsdadggggg

得到:

16  001
16  002
23  001
23  002
awk '{print $1,substr($2,1,3)}'
awk 'BEGIN{FIELDWIDTH="2 2:3"}{print $1,$2}' a.txt

行列轉換

name age
alice 21
ryan 30

轉換得到:

name alice ryan
age 21 30
awk '
    {
      for(i=1;i<=NF;i++){
        if(!(i in arr)){
          arr[i]=$i
        } else {
            arr[i]=arr[i]" "$i
        }
      }
    }
    END{
        for(i=1;i<=NF;i++){
            print arr[i]
        }
    }
' a.txt

行列轉換2

文件內容:

74683 1001
74683 1002
74683 1011
74684 1000
74684 1001
74684 1002
74685 1001
74685 1011
74686 1000
....
100085 1000
100085 1001

文件就兩列,希望處理成

74683 1001 1002 1011
74684 1000 1001 1002
...

就是只要第一列數字相同, 就把他們的第二列放一行上,中間空格分開

{
  if($1 in arr){
    arr[$1] = arr[$1]" "$2
  } else {
    arr[$1] = $2
  }
  
}

END{
  for(i in arr){
    printf "%s %s\n",i,arr[i]
  }
}

篩選給定時間範圍內的日誌

grep/sed/awk用正則去篩選日誌時,如果要精確到小時、分鐘、秒,則非常難以實現。

但是awk提供了mktime()函數,它可以將時間轉換成epoch時間值。

# 2019-11-10 03:42:40轉換成epoch
$ awk 'BEGIN{print mktime("2019 11 10 03 42 40")}'
1573328560

藉此,可以取得日誌中的時間字符串部分,再將它們的年、月、日、時、分、秒都取出來,然後放入mktime()構建成對應的epoch值。因為epoch值是數值,所以可以比較大小,從而決定時間的大小。

下面strptime1()實現的是將2019-11-10T03:42:40+08:00格式的字符串轉換成epoch值,然後和which_time比較大小即可篩選出精確到秒的日誌。

下面strptime2()實現的是將10/Nov/2019:23:53:44+08:00格式的字符串轉換成epoch值,然後和which_time比較大小即可篩選出精確到秒的日誌。

BEGIN{
  # 要篩選什麼時間的日誌,將其時間構建成epoch值
  which_time = mktime("2019 11 10 03 42 40")
}

{
  # 取出日誌中的日期時間字符串部分
  match($0,"^.*\\[(.*)\\].*",arr)
  
  # 將日期時間字符串轉換為epoch值
  tmp_time = strptime2(arr[1])
  
  # 通過比較epoch值來比較時間大小
  if(tmp_time > which_time){
    print 
  }
}

# 構建的時間字符串格式為:"10/Nov/2019:23:53:44+08:00"
function strptime2(str   ,dt_str,arr,Y,M,D,H,m,S) {
  dt_str = gensub("[/:+]"," ","g",str)
  # dt_sr = "10 Nov 2019 23 53 44 08 00"
  split(dt_str,arr," ")
  Y=arr[3]
  M=mon_map(arr[2])
  D=arr[1]
  H=arr[4]
  m=arr[5]
  S=arr[6]
  return mktime(sprintf("%s %s %s %s %s %s",Y,M,D,H,m,S))
}

function mon_map(str   ,mons){
  mons["Jan"]=1
  mons["Feb"]=2
  mons["Mar"]=3
  mons["Apr"]=4
  mons["May"]=5
  mons["Jun"]=6
  mons["Jul"]=7
  mons["Aug"]=8
  mons["Sep"]=9
  mons["Oct"]=10
  mons["Nov"]=11
  mons["Dec"]=12
  return mons[str]
}

去掉/**/中間的註釋

示例數據:

/*AAAAAAAAAA*/
1111
222

/*aaaaaaaaa*/
32323
12341234
12134 /*bbbbbbbbbb*/ 132412

14534122
/*
    cccccccccc
*/
xxxxxx /*ddddddddddd
    cccccccccc
    eeeeeee
*/ yyyyyyyy
5642341

前後段落關係判斷

從如下類型的文件中,找出false段的前一段為i-order的段,同時輸出這兩段。

2019-09-12 07:16:27 [-][
  'data' => [
    'http://192.168.100.20:2800/api/payment/i-order',
  ],
]
2019-09-12 07:16:27 [-][
  'data' => [
    false,
  ],
]
2019-09-21 07:16:27 [-][
  'data' => [
    'http://192.168.100.20:2800/api/payment/i-order',
  ],
]
2019-09-21 07:16:27 [-][
  'data' => [
    'http://192.168.100.20:2800/api/payment/i-user',
  ],
]
2019-09-17 18:34:37 [-][
  'data' => [
    false,
  ],
]
BEGIN{
  RS="]\n"
  ORS=RS
}
{
  if(/false/ && prev ~ /i-order/){
    print tmp
    print
  }
  tmp=$0
}

兩個文件的處理

有兩個文件file1和file2,這兩個文件格式都是一樣的。

需求:先把文件2的第五列刪除,然後用文件2的第一列減去文件一的第一列,把所得結果對應的貼到原來第五列的位置,請問這個腳本該怎麼編寫?

file1:
50.481  64.634  40.573  1.00  0.00
51.877  65.004  40.226  1.00  0.00
52.258  64.681  39.113  1.00  0.00
52.418  65.846  40.925  1.00  0.00
49.515  65.641  40.554  1.00  0.00
49.802  66.666  40.358  1.00  0.00
48.176  65.344  40.766  1.00  0.00
47.428  66.127  40.732  1.00  0.00
51.087  62.165  40.940  1.00  0.00
52.289  62.334  40.897  1.00  0.00
file2:
48.420  62.001  41.252  1.00  0.00
45.555  61.598  41.361  1.00  0.00
45.815  61.402  40.325  1.00  0.00
44.873  60.641  42.111  1.00  0.00
44.617  59.688  41.648  1.00  0.00
44.500  60.911  43.433  1.00  0.00
43.691  59.887  44.228  1.00  0.00
43.980  58.629  43.859  1.00  0.00
42.372  60.069  44.032  1.00  0.00
43.914  59.977  45.551  1.00  0.00

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※公開收購3c價格,不怕被賤賣!

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

Rust 入門 (二)

我認為學習計算機語言,應該先用後學,這一節,我們來實現一個猜数字的小遊戲。

先簡單介紹一個這個遊戲的內容:遊戲先生成一個1到100之間的任意一個数字,然後我們輸入自己猜測的数字,遊戲會告訴我們輸入的数字太大還是太小,然後我們重新輸入新的数字,直到猜到遊戲生成的数字,然後遊戲結束。

創建項目

製作遊戲的第一步先創建項目,創建方法和上一節一樣,使用 cargo 來創建一個名為 guessing_game 的項目。

cargo new guessing_game && cd guessing_game

項目創建完成,可以運行一下,如果程序打印出 Hello, World! 則證明程序創建完成,運行命令如下:

cargo run 

讀取猜測的数字

正式寫遊戲的第一步,讓遊戲先讀取我們猜測的数字。我們可以先把打印語句換成提示我們輸入数字的提示語句。

use std::io;

fn main() {
    println!("猜測数字遊戲,請輸入您猜測的数字。");

    let mut guess = String::new();

    io::stdin().read_line(&mut guess).expect("讀取数字失敗!");

    println!("您猜測的数字是:{}", guess);
}

這段代碼包含了大量的信息,我們一行一行地過一遍。
1.因為我們需要讀取用戶的輸入,然後把它作為結果打印出來,所以需要把 標準庫(被稱作 std )中的 io 依賴引入當前作用域。
2.在主函數中寫方法體,首先是打印提示語,不說了。
3.然後創建一個用於保存即將輸入的字符串的 String 類型的變量 guess。
4.把控制台輸入的数字讀取到變量 guess 中,如果讀取失敗,則打印 “讀取数字失敗!” 的字符串。
5.把讀取的数字再打印到控制台。

注:這段程序的細節暫時先不深究了,後續文章會一一解釋清楚。

測試一下這段程序:

cargo run                                    
   Compiling guessing_game v0.1.0 (/Users/shanpengfei/work/rust-work-space/study/guessing_game)
    Finished dev [unoptimized + debuginfo] target(s) in 1.01s
     Running `target/debug/guessing_game`
猜測数字遊戲,請輸入您猜測的数字。
2
您猜測的数字是:2

生成隨機數

我們的遊戲需要創建一個隨機數,供我們去猜測,這個数字要求每次啟動遊戲時都是不相同的,這樣遊戲才更加有意思。接下來我們在遊戲中生成一個1到100的隨機數。但是 rust 沒有在它的標準庫中提供生成隨機數的方法,不過沒關係,它提供了生成隨機數的名為 rand 的 crate。我們來引入一下生成隨機數的 crate,修改 Cargo.toml 文件:

[dependencies]

rand = "^0.3.14"

只需要在 [dependencies] 下面添加需要的 crate 即可。這次添加的 crate 名字是 rand,版本號 0.3.14, 而 ^ 的意思是兼容 0.3.14 版本的任何版本都可以。然後我們編譯一下程序,就會自動下載引入的依賴:

cargo build                                      
    Updating crates.io index
   Compiling libc v0.2.65
   Compiling rand v0.4.6
   Compiling rand v0.3.23
   Compiling guessing_game v0.1.0 (/Users/shanpengfei/work/rust-work-space/study/guessing_game)
    Finished dev [unoptimized + debuginfo] target(s) in 1m 13s

引入了生成隨機數和 crate 后,我們來生成一下需要的 crate,代碼如下:

use std::io;
use rand::Rng;

fn main() {
    let secret_number = rand::thread_rng().gen_range(1, 101);

    println!("生成的隨機数字是:{}", secret_number);

    println!("猜測数字遊戲,請輸入您猜測的数字。");

    let mut guess = String::new();

    io::stdin().read_line(&mut guess).expect("讀取数字失敗!");

    println!("您猜測的数字是:{}", guess);
}

可以看到我們在前面代碼的基礎上添加了三行代碼:
1.第一行是引入生成隨機數的依賴。
2.第二行是生成一個隨機數,隨機數的範圍是 [1, 101),區間是左閉右開,說人話就是1到100。
3.第三行是打印生成的隨機數。
然後我們測試一下添加的隨機數是否生效:

cargo run                                    
   Compiling guessing_game v0.1.0 (/Users/shanpengfei/work/rust-work-space/study/guessing_game)
    Finished dev [unoptimized + debuginfo] target(s) in 0.45s
     Running `target/debug/guessing_game`
生成的隨機数字是:79
猜測数字遊戲,請輸入您猜測的数字。
6
您猜測的数字是:6

比較隨機數和猜測數

現在我們可以輸入自己猜測的数字,也可以生成隨機数字了,那麼接下來就是比較二者的大小了。但是在比較之前還有個問題,控制台輸入的数字是 string 類型的,而隨機生成的数字是無符號32位整型(u32),二者不類型不一致,不能作比較,因此,在比較之前,我們應該先把控制台輸入的 string 類型的数字轉成u32類型的,代碼如下:

use std::io;
use std::cmp::Ordering;
use rand::Rng;

fn main() {
    let secret_number = rand::thread_rng().gen_range(1, 101);

    println!("生成的隨機数字是:{}", secret_number);

    println!("猜測数字遊戲,請輸入您猜測的数字。");

    let mut guess = String::new();

    io::stdin().read_line(&mut guess).expect("讀取数字失敗!");

    let guess: u32 = guess.trim().parse().expect("請輸入一個数字!");

    println!("您猜測的数字是:{}", guess);

    match guess.cmp(&secret_number) {
        Ordering::Less => println!("您猜測的数字太小了!"),
        Ordering::Greater => println!("您猜測的数字太大了!"),
        Ordering::Equal => println!("恭喜您,猜對了!"),
    }
}

可見,我們在三個位置添加了代碼:
1.從標準庫中添加了比較的依賴。
2.把輸入的数字類型成u32類型,如果輸入的不是数字,則轉換失敗,打印出錯誤信息。
3.最後一部分就是比較一下二者的大小,並打印出比較的結果。
好了,我們先測試一下吧,這裏我們只測正確的輸入:

cargo run                                     101 ↵
   Compiling guessing_game v0.1.0 (/Users/shanpengfei/work/rust-work-space/study/guessing_game)
    Finished dev [unoptimized + debuginfo] target(s) in 0.42s
     Running `target/debug/guessing_game`
生成的隨機数字是:53
猜測数字遊戲,請輸入您猜測的数字。
4
您猜測的数字是:4
您猜測的数字太小了!

添加循環

我們發現,我們只輸入了一次,遊戲就結束了,這顯然不符合我們的預期。我們的預期是,我們可以一直猜一直猜,直到猜中才讓遊戲結束,那應該怎麼修改一下呢?添加一個循環,代碼如下:

use std::io;
use std::cmp::Ordering;
use rand::Rng;

fn main() {
    let secret_number = rand::thread_rng().gen_range(1, 101);

    println!("生成的隨機数字是:{}", secret_number);

    loop {

        println!("猜測数字遊戲,請輸入您猜測的数字。");

        let mut guess = String::new();

        io::stdin().read_line(&mut guess).expect("讀取数字失敗!");

        let guess: u32 = guess.trim().parse().expect("請輸入一個数字!");

        println!("您猜測的数字是:{}", guess);

        match guess.cmp(&secret_number) {
            Ordering::Less => println!("您猜測的数字太小了!"),
            Ordering::Greater => println!("您猜測的数字太大了!"),
            Ordering::Equal => println!("恭喜您,猜對了!"),
        }
    }
}

這裏修改得比較簡單,只需要添加一個名叫 loop 的關鍵字,然後把需要循環的內容放在 {} 中即可,然後我們測試一下:

cargo run                                    
   Compiling guessing_game v0.1.0 (/Users/shanpengfei/work/rust-work-space/study/guessing_game)
    Finished dev [unoptimized + debuginfo] target(s) in 0.38s
     Running `target/debug/guessing_game`
生成的隨機数字是:71
猜測数字遊戲,請輸入您猜測的数字。
50
您猜測的数字是:50
您猜測的数字太小了!
猜測数字遊戲,請輸入您猜測的数字。
71
您猜測的数字是:71
恭喜您,猜對了!
猜測数字遊戲,請輸入您猜測的数字。
45
您猜測的数字是:45
您猜測的数字太小了!
猜測数字遊戲,請輸入
t
thread 'main' panicked at '請輸入一個数字!: ParseIntError { kind: InvalidDigit }', src/libcore/result.rs:1165:5
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace.

我們的遊戲可以多次輸入了,但是有沒有發現一些問題呢?
1.遊戲直接告訴我們生成的数字了,那就不用猜了,直接輸入就好了。
2.當我們猜對后,遊戲沒有結束。
3.當我們輸入的內容不是数字的時候,才會結束遊戲,而且不僅打印了我們預期的錯誤信息,還打印了其它信息。
接下來,我們把這些問題依次修改,代碼如下:

use std::io;
use std::cmp::Ordering;
use rand::Rng;

fn main() {
    let secret_number = rand::thread_rng().gen_range(1, 101);

    // println!("生成的隨機数字是:{}", secret_number);

    loop {

        println!("猜測数字遊戲,請輸入您猜測的数字。");

        let mut guess = String::new();

        io::stdin().read_line(&mut guess).expect("讀取数字失敗!");

        let guess: u32 = match guess.trim().parse() {
            Ok(num) => num,
            Err(_) => continue,
        };

        println!("您猜測的数字是:{}", guess);

        match guess.cmp(&secret_number) {
            Ordering::Less => println!("您猜測的数字太小了!"),
            Ordering::Greater => println!("您猜測的数字太大了!"),
            Ordering::Equal => {
                println!("恭喜您,猜對了!");
                break;
            }
        }
    }
}

這三處錯誤的修改方式依次是:
1.把打印隨機數的代碼註釋掉。
2.在做類型轉換時,使用 match 關鍵字作判斷,如果轉化成功,則返迴轉化后的結果,如果轉化失敗,不管因為什麼原因失敗,都直接跳出本次循環。
3.在做二個数字大小判斷時,如果判斷相等,則結束循環。
我們來測試一下修改的結果:

cargo run                                    
   Compiling guessing_game v0.1.0 (/Users/shanpengfei/work/rust-work-space/study/guessing_game)
    Finished dev [unoptimized + debuginfo] target(s) in 0.38s
     Running `target/debug/guessing_game`
猜測数字遊戲,請輸入您猜測的数字。
50
您猜測的数字是:50
您猜測的数字太小了!
猜測数字遊戲,請輸入您猜測的数字。
r
猜測数字遊戲,請輸入您猜測的数字。
75
您猜測的数字是:75
您猜測的数字太小了!
猜測数字遊戲,請輸入您猜測的数字。
87
您猜測的数字是:87
您猜測的数字太大了!
猜測数字遊戲,請輸入您猜測的数字。
81
您猜測的数字是:81
恭喜您,猜對了!

可以看到我們的遊戲製作完成了~~

歡迎閱讀單鵬飛的學習筆記

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※公開收購3c價格,不怕被賤賣!

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

使用Docker搭建maven私服 及常規使用方法

安裝-登錄-配置

下載鏡像
docker pull sonatype/nexus3
運行
docker run -d -p 9998:8081 --name nexus --restart=always sonatype/nexus3

進入容器中查看密碼是多少

docker exec -it 容器名/容器id /bin/bash

根據上圖的提示進入到指定的目錄,查看密碼是啥

繼續訪問, 修改密碼

修改私服的中央倉庫位置,如果嫌國外的站點太慢了, 我們就將其修改成阿里雲,修改方式就是替換一下鏈接就ok

創建hosted類型的倉庫

選擇創建的倉庫類型是hosted類型,為什麼非得選擇這種類型呢? 如下錶中解密

項目 具體說明
hosted 本地存儲。像官方倉庫一樣提供本地私庫功能
proxy 提供代理其它倉庫的類型
group 組類型,能夠組合多個倉庫為一個地址提供服務

繼續創建

創建一個私服的帳號,然後在我的windows本中本地maven添加進去私服的新創建的這個用戶的信息, 進而可以使用這個用戶往私服中發布jar包

填寫用戶的信息

找到本機的settings.xml配置文件, 將我們剛剛創建的私服添加進去

ok, 下面去idea中發布jar包

發布

首先是將連接私服的用戶信息配置進配置文件

  1. id 就是上圖中的id
  2. url: 在nexus可視化界面中找到我們在上面創建的倉庫可以找到url

準備腳本

 <!--添加build依賴,表示可以發布jar-->
    <build>
        <plugins>
            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-deploy-plugin</artifactId>
                <version>2.8</version>
            </plugin>
            <!--發布源碼的插件-->
            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-source-plugin</artifactId>
                <version>2.2.1</version>
                <executions>
                    <execution>
                        <phase>package</phase>
                        <goals>
                            <goal>jar</goal>
                        </goals>
                    </execution>
                </executions>
            </plugin>
        </plugins>
    </build>

發布命令:

mvn deploy

踩坑

  • 再發布之前檢查一下idea中關於maven的配置,使用我們剛才修改的settings.xml配置文件 , 不然這就是個坑,會一直deploy失敗
  • 上面的版本一定得和我們創建的倉庫的類型對應起來, 否則會報錯失敗

發布成果后我們繼續查看結果, 可

詳細結果

拉取使用

添加如下的在pom文件中依賴就ok

<dependency>
  <groupId>com.changwu</groupId>
  <artifactId>lawyer-eureka</artifactId>
  <version>1.0-RELEASE</version>
</dependency>
 <repository>
     <id>changwu</id>
     <name>lawyer-lover-release</name>
     <url>http://139.x.xx.235:9998/repository/lawyer-lover-release/</url>
</repository>

歡迎關注我的博客, 我將會把整理的docker(從入門到部署微服務)分享全套筆記

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※公開收購3c價格,不怕被賤賣!

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

PowerMock學習(六)之Mock Final的使用

Mock Final

mockfinal相對來說就比較簡單了,使用powermock來測試使用final修飾的method或class,比較簡單,接口調用部分,還是service調用dao。

對於接口及場景這裏就不細說了,特別簡單。

service層

具體代碼示例如下:

package com.rongrong.powermock.mockfinal;

/**
 * @author rongrong
 * @version 1.0
 * @date 2019/11/27 21:29
 */
public class StudentFinalService {

    private StudentFinalDao studentFinalDao;

    public StudentFinalService(StudentFinalDao studentFinalDao) {
        this.studentFinalDao = studentFinalDao;
    }

    public void createStudent(Student student) {
        studentFinalDao.isInsert(student);
    }
}

dao層

為了模擬測試,我在dao層的類加了一個final關鍵字進行修飾,也就是這個類不允許被繼承了。

具體代碼如下:

package com.rongrong.powermock.mockfinal;


/**
 * @author rongrong
 * @version 1.0
 * @date 2019/11/27 21:20
 */
final public class StudentFinalDao {

    public Boolean isInsert(Student student){
        throw new UnsupportedOperationException();
    }
}

進行單元測試

為了區分powermock與Easymock的區別,我們先採用EasyMock測試,這裏先忽略EasyMock的用法,有興趣的同學可自行去嘗試學習。

使用EasyMock進行測試

具體代碼示例如下:

    @Test
    public void testStudentFinalServiceWithEasyMock(){
        //mock對象
        StudentFinalDao studentFinalDao = EasyMock.createMock(StudentFinalDao.class);
        Student student = new Student();
        //mock調用,默認返回成功
        EasyMock.expect(studentFinalDao.isInsert(student)).andReturn(true);
        EasyMock.replay(studentFinalDao);
        StudentFinalService studentFinalService = new StudentFinalService(studentFinalDao);
        studentFinalService.createStudent(student);
        EasyMock.verify(studentFinalDao);
    }

我們先來運行下這個單元測試,會發現運行報錯,具體如下圖显示:


 很明顯由於有final關鍵字修飾后,導致不能讓測試成功,我們可以刪除final關鍵再來測試一下,結果發現,測試通過。

使用PowerMock進行測試

具體代碼示例如下:

package com.rongrong.powermock.mockfinal;

import org.junit.Test;
import org.junit.runner.RunWith;
import org.mockito.Mockito;
import org.powermock.api.mockito.PowerMockito;
import org.powermock.core.classloader.annotations.PrepareForTest;
import org.powermock.modules.junit4.PowerMockRunner;

/**
 * @author rongrong
 * @version 1.0
 * @date 2019/11/27 22:10
 */
@RunWith(PowerMockRunner.class)
@PrepareForTest(StudentFinalDao.class)
public class TestStudentFinalService {

    @Test
    public void testStudentFinalServiceWithPowerMock(){
        StudentFinalDao studentFinalDao = PowerMockito.mock(StudentFinalDao.class);
        Student student = new Student();
        PowerMockito.when(studentFinalDao.isInsert(student)).thenReturn(true);
        StudentFinalService studentFinalService = new StudentFinalService(studentFinalDao);
        studentFinalService.createStudent(student);
        Mockito.verify(studentFinalDao).isInsert(student);
    }
}

運行上面的單元測試時,會發現運行通過!!

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品在網路上成為最夯、最多人討論的話題?

※高價收購3C產品,價格不怕你比較

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

Jetpack 提供免費 Asset CDN 為你的 WordPress 核心檔案分流加速

如果有經常閱讀免費資源網路社群的架站相關教學,應該知道我相當重視速度,而提升網站載入速度方法很多,最基本的是使用更快、更好的網站空間,例如 Cloudways 協助使用者部屬最佳化 WordPress 環境,除此之外,選用 Cloudflare 這類 CDN 服務不但能強化網站安全,更重要的是利用各區域節點達到加速、節省流量等效果,對於架站的基礎建設來說是非常值得投入的選項。

如果你本身使用 WordPress 架站,特別推薦官方提供的 Photon CDN 免費功能(這是包含在 Jetpack 外掛程式的其中一個模組),可針對圖片分流加速,雖然會犧牲圖片品質,但能大幅降低流量耗費,如果搭配延遲載入(Lazy Load)等功能將有非常棒的效果,不過也不是毫無缺點,例如圖片會因壓縮而稍微降低畫質,除此之外,快取(Cache)期限永久不失效,若是圖片編輯更新,只能重新命名圖片才能獲取新的圖片檔案。

以往 Photon CDN 只能針對 PNG、JPG 或 GIF 圖片格式進行處理,最近在 Jetpack 6.6 更新後確定加入一項全新「Asset CDN」模組,簡單來說,這是對 WordPress 核心和 Jetpack 相關檔案進行分流加速的新功能,可以透過 WordPress 官方的 CDN 伺服器處理 CSS、JS 檔案,不過僅止於 WordPress 核心及 Jetpack 檔案,像是 jQuery、Genericons、Dashicons 和一些在 Jetpack 外掛模組中會用到的檔案。

雖然 Asset CDN 不支援佈景主題或第三方檔案,但站長們會發現 WordPress 網站開啟時會載入不少核心檔案,如果又有使用 Jetpack 外掛的話那麼檔案會更多,開啟 Asset CDN 將能夠直接取代鏈結並改由 WordPress CDN 提供檔案,降低主機負載,獲取檔案也有加速及壓縮效果。

目前這個模組還在測試階段,必須透過特殊方式才能將它啟用,或許也還不夠完善,有興趣的話可以照著本文教學將它啟用,即可在網站中測試這個全新的加速功能。

外掛名稱:Jetpack by WordPress
外掛鏈結:https://zh-tw.jetpack.com/

使用教學

STEP 1

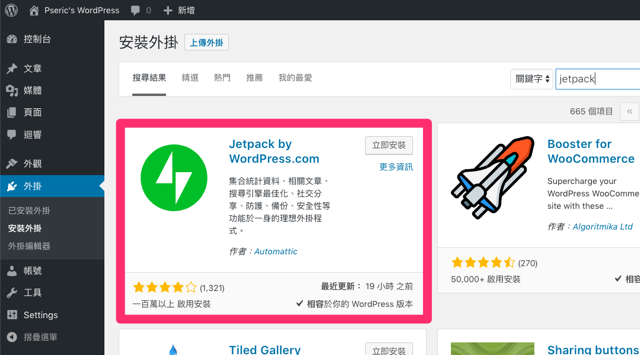
開啟 WordPress 控制台,從「外掛」的「安裝外掛」中找到 Jetpack by WordPress.com 功能,接著點選「立即安裝」即可將它下載、安裝到你的網站中。

如果沒有外掛選項,有可能你使用的是 WordPress.com,WordPress.com 和 WordPress 不同,可以參考「當 WordPress 遇上 WordPress.com:它們是相同的嗎?」瞭解兩者的差異。

STEP 2

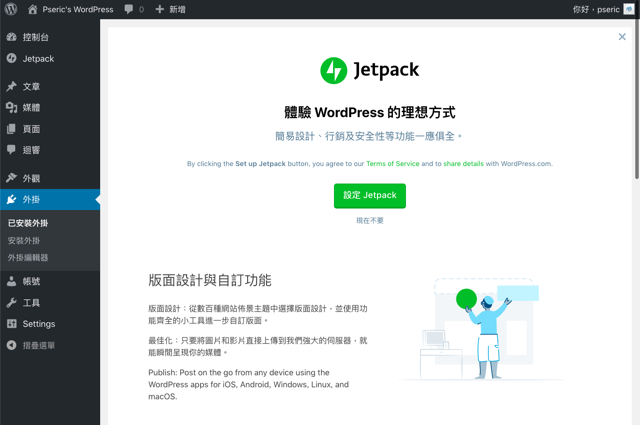
啟用後會先出現 Jetpack 設定畫面,點選「設定 Jetpack」開始進行,這個外掛比較特別的是必須連結使用者的 WordPress.com 帳號,如此一來才能使用相關模組。

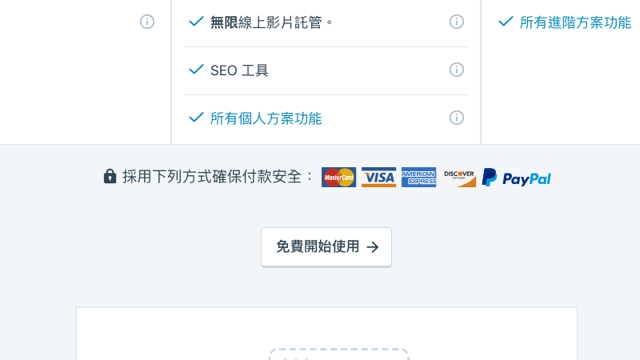
WordPress.com 免費註冊、申請帳號過程並不算太困難,連結後會跳出是否允許以某個身分連結 WordPress 網站的提示訊息,核准後會跳到方案規格,目前免費版在頁面下方,點選「免費開始使用」就能跳過付費並免費使用 Jetpack 相關功能。

STEP 3

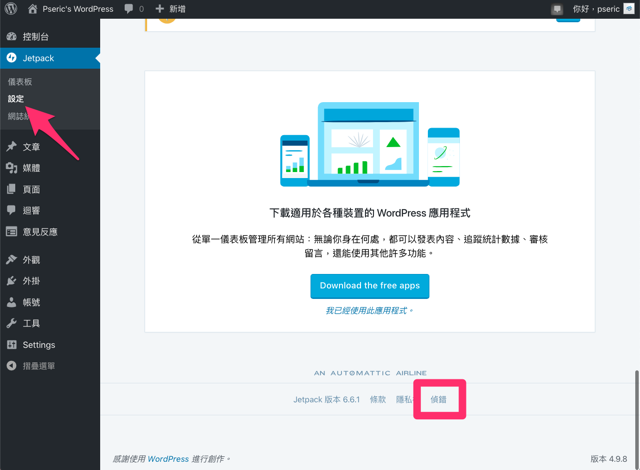
設定完 Jetpack 並在網站中開始運作後,點選 WordPress 控制台左側選單的 Jetpack 並找到「設定」選項,接著將網頁拉到最下方,點選「偵錯」鏈結(灰色文字不是很明顯請自己找一下)。

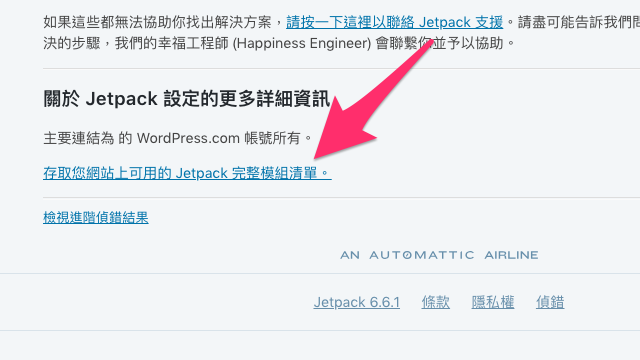
稍待片刻,Jetpack 會測試網站是否可以正常連接,這部分結果無論為何並不影響到接下來的使用,有些伺服器可能會有防火牆或一些阻擋規則,但只要能將網站和 WordPress 帳號連接就沒問題。

將頁面往下拖曳,點選「存取您網站上可用的 Jetpack 完整模組清單」鏈結。

STEP 4

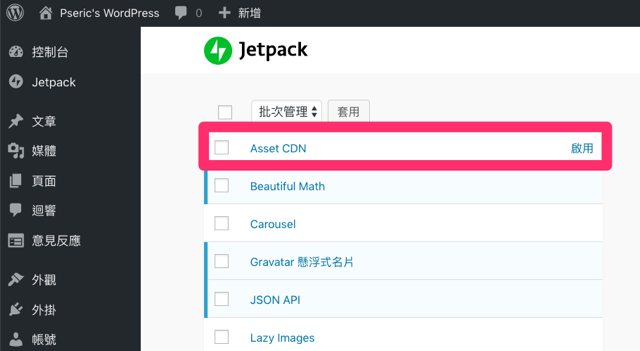
從模組列表中找到「Asset CDN」並點選「啟用」後就能開啟此功能,因為這個模組還在測試階段,必須使用此方法才能找到開啟,未來如果加入 Jetpack 成為正式版就不用這麼做,直接於控制台將它啟用即可。

開啟 Asset CDN 後,返回 WordPress 前台檢視原始碼,就能看到原有 WordPress 核心檔案及 Jetpack 相關檔案路徑改為從 https://c0.wp.com/ 獲取檔案,看起來會像這樣:

本站聲明:網站內容來源免費資源網路社群https://free.com.tw,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置、套版網頁設計、台北網站改版設計、台北RWD響應式網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

NGINXConfig 網頁伺服器 NGINX 設定檔產生器,依需求產生各種 conf 檔

十年前開始自己研究架站,跟很多人一樣都是從 Apache 開始,後來出現 Nginx 後普遍的作法是將它拿來做反向代理(Reveres Proxy),既有的網頁伺服器就會退居後端,由前端的 Nginx 負責相關工作,依照經驗可以提升網站速度,亦能降低負載,在原有硬體規格上承載更多的訪客同時上線(Nginx 本身還能夠針對靜態檔案進行快取)。因為我最初是從 Apache 開始學習,早期都得和設定檔奮戰,一直到 Nginx 我才發現它的設定檔夠簡潔,簡單到我好像無法直接編修。

這可能是許多 Nginx 使用者的心聲,即使設定檔很簡潔但在編寫時並不那麼容易,必須去找一些範例動手修改,尤其是從 Apache 轉到 Nginx 都很希望有個轉換工具將設定檔轉為 Nginx 適用版本,可惜大多數情況下還是得花時間自行檢視和編寫,後來我乾脆都用 ServerPilot 或 Cloudways 這類自動化佈署服務,可以省下更多時間,避免出錯。

不過如果你想研究架站,想要手動建置 Nginx 網頁伺服器,即使再困難的設定檔都得硬著頭皮挑戰一下,接下來「NGINXConfig.io」是你必須收藏起來的「神兵」!

這是一款開放原始碼免費線上工具,用途是讓使用者快速產生 Nginx 所需要的各種設定檔,聽起來非常酷對吧?NGINXConfig 透過網頁介面讓使用者進行相關設定,最終產生對應的各個 .conf 檔,還能將產生的所有設定檔下載備份。

依照 NGINXConfig 說明,這個工具可以設定的項目包括網站基本選項、HTTPS、安全相關選項、PHP、Python、Routing、Cache、Reverse Proxy、Logging 等等,已經內建幾種常用的架站項目,例如前後端、Node.js、單頁面應用程式、WordPress、Drupal 和 Magento,點選後可針對該項需求先啟用特定選項。

網站名稱:NGINXConfig
網站鏈結:https://nginxconfig.io/

使用教學

STEP 1

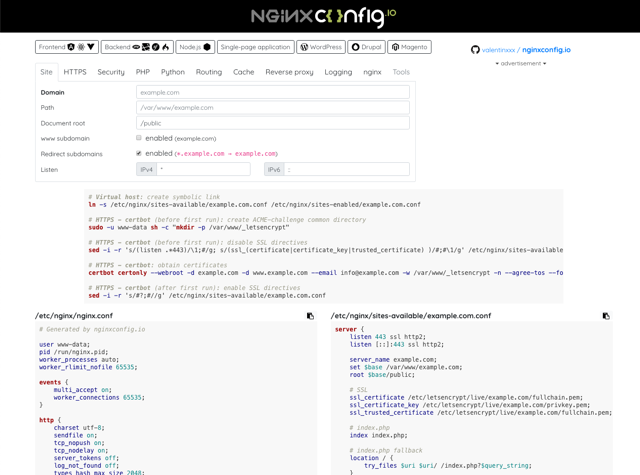
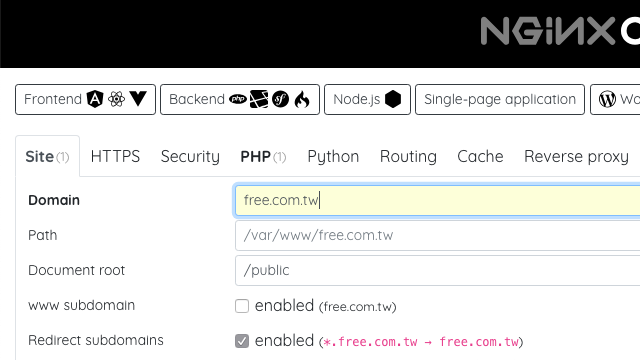
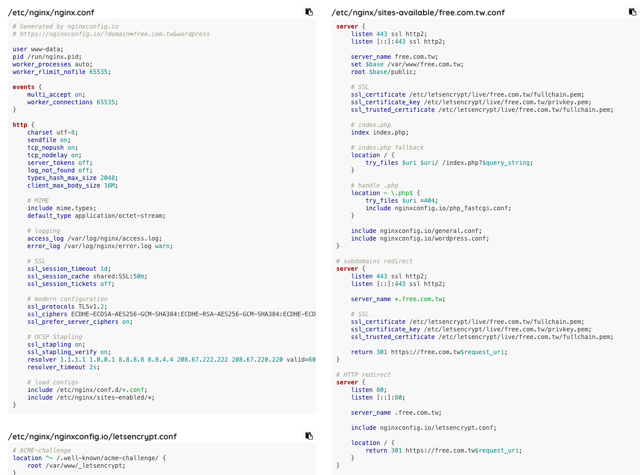
下圖就是 NGINXConfig 操作介面,主要設定選項集中在網頁上半部,中間有一些常用到的指令和說明註解。

在上方選項進行相關設定,下方的 .conf 設定檔就會即時更新。

STEP 2

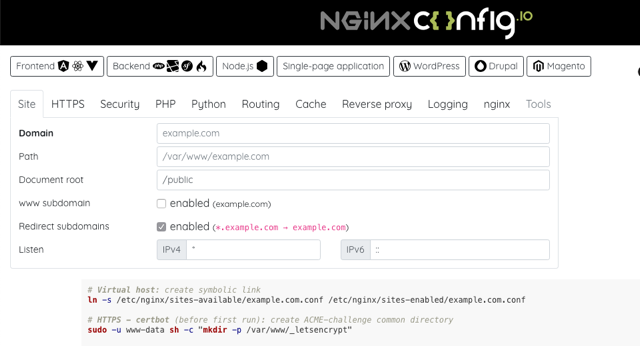
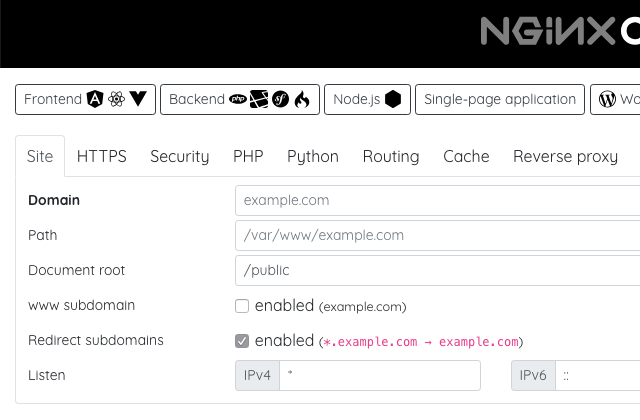
NGINXConfig 主要設定項目都以標籤方式顯示於上方,包括一般網站設定、HTTPS、安全性、PHP、Python、Routing、Cache 和 Reverse Proxy 等等,如果有架站經驗的話應該不會太難懂,比較棒的是欄位上也有範例格式可供參考。

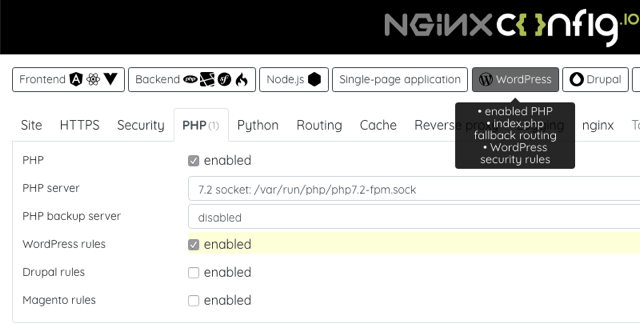
如果 Nginx 網頁伺服器要拿來運作特定程式,NGINXConfig 也提供一些選項,點選後就會預先選取所需的相關功能,例如選取 WordPress 後會啟用 WordPress 規則。

STEP 3

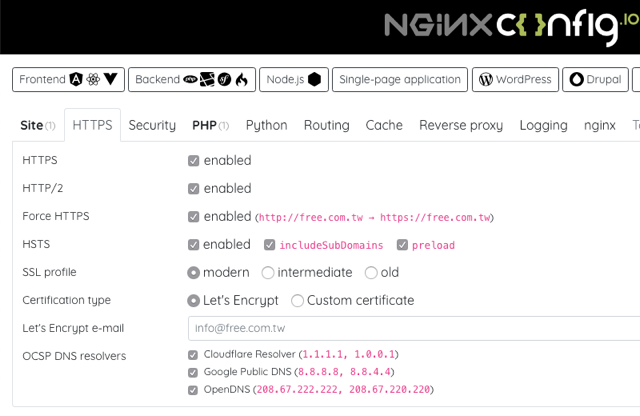
NGINXConfig 特色是讓原有的 Nginx 設定檔變得更容易理解。

像是 HTTPS、HTTP/2、Force HTTPS、HSTS 等等選項可能在 Nginx 都不是那麼容易編寫,透過 NGINXConfig 讓選項變成互動式開關,只要在網頁中切換,下方的設定檔就會即時更新。

最後,將 .conf 設定檔複製、貼回自己網頁伺服器對應的路徑,重新啟動 Nginx 就能夠完成套用修改。當然細節部分我就不在文章裡多做闡述,本文是想推薦 NGINXConfig 這款 Nginx 設定檔產生器,至於要怎麼樣安裝、架設 Nginx 伺服器可能得自行去其他更專業的網站爬文。

STEP 4

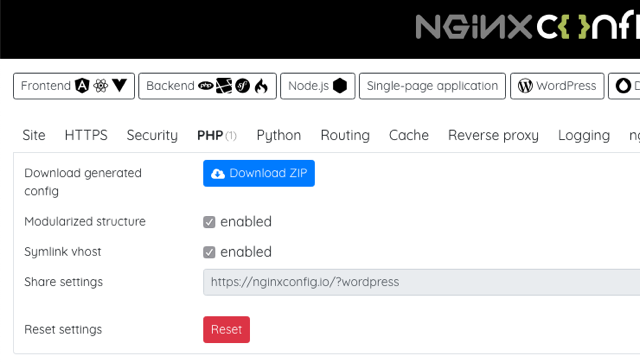
如果你想將辛苦修改好的設定檔備份、保存下來,切換到「Tools」可以找到打包下載為 ZIP 格式的下載工具,比較特別的是 NGINXConfig 內建分享功能,找到底下的分享網址還能將相關設定值透過鏈結傳給其他人檢視。

值得一試的三個理由:

  1. 協助使用者快速產生 Nginx 設定檔
  2. 可針對特定需求或程式先起用特定選項
  3. 設定檔可下載備份為 Zip 格式或產生分享鏈結

推薦閱讀:

本站聲明:網站內容來源免費資源網路社群https://free.com.tw,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置、套版網頁設計、台北網站改版設計、台北RWD響應式網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益