Elasticsearch從入門到放棄:文檔CRUD要牢記

在Elasticsearch中,文檔(document)是所有可搜索數據的最小單位。它被序列化成JSON存儲在Elasticsearch中。每個文檔都會有一個唯一ID,這個ID你可以自己指定或者交給Elasticsearch自動生成。

如果延續我們之前不恰當的對比RDMS的話,我認為文檔可以類比成關係型數據庫中的表。

元數據

前面我們提到,每個文檔都有一個唯一ID來標識,獲取文檔時,“_id”字段記錄的就是文檔的唯一ID,它是元數據之一。當然,文檔還有一些其他的元數據,下面我們來一一介紹

  • _index:文檔所屬的索引名
  • _type:文檔所屬的type
  • _id:文檔的唯一ID

有了這三個,我們就可以唯一確定一個document了,當然,7.0版本以後我們已經不需要_type了。接下來我們再來看看其他的一些元數據

  • _source:文檔的原始JSON數據
  • _field_names:該字段用於索引文檔中值不為null的字段名,主要用於exists請求查找指定字段是否為空
  • _ignore:這個字段用於索引和存儲文檔中每個由於異常(開啟了ignore_malformed)而被忽略的字段的名稱
  • _meta:該字段用於存儲一些自定義的元數據信息
  • _routing:用來指定數據落在哪個分片上,默認值是Id
  • _version:文檔的版本信息
  • _score:相關性打分

創建文檔

創建文檔有以下4種方法:

  • PUT /<index>/_doc/<_id>
  • POST /<index>/_doc/
  • PUT /<index>/_create/<_id>
  • POST /<index>/_create/<_id>

這四種方法的區別是,如果不指定id,則Elasticsearch會自動生成一個id。如果使用_create的方法,則必須保證文檔不存在,而使用_doc方法的話,既可以創建新的文檔,也可以更新已存在的文檔。

在創建文檔時,還可以選擇一些參數。

請求參數

  • if_seq_no:當文檔的序列號是指定值時才更新
  • if_primary_term:當文檔的primary term是指定值時才更新
  • op_type:如果設置為create則指定id的文檔必須不存在,否則操作失敗。有效值為index或create,默認為index
  • op_type:指定預處理的管道id
  • refresh:如果設置為true,則立即刷新受影響的分片。如果是wait_for,則會等到刷新分片后,此次操作才對搜索可見。如果是false,則不會刷新分片。默認值為false
  • routing:指定路由到的主分片
  • timeout:指定響應時間,默認是30秒
  • master_timeout:連接主節點的響應時長,默認是30秒
  • version:顯式的指定版本號
  • version_type:指定版本號類型:internal、 external、external_gte、force
  • wait_for_active_shards:處理操作之前,必須保持活躍的分片副本數量,可以設置為all或者任意正整數。默認是1,即只需要主分片活躍。

響應包體

  • **_shards**:提供分片的信息
  • **_shards.total**:創建了文檔的總分片數量
  • **_shards.successful**:成功創建文檔分片的數量
  • **_shards.failed**:創建文檔失敗的分片數量
  • **_index**:文檔所屬索引
  • **_type**:文檔所屬type,目前只支持_doc
  • **_id**:文檔的id
  • **_version**:文檔的版本號
  • **_seq_no**:文檔的序列號
  • **_primary_term**:文檔的主要術語
  • result:索引的結果,created或者updated

我們在創建文檔時,如果指定的索引不存在,則ES會自動為我們創建索引。這一操作是可以通過設置中的action.auto_create_index字段來控制的,默認是true。你可以修改這個字段,實現指定某些索引可以自動創建或者所有索引都不能自動創建的目的。

更新文檔

了解了如何創建文檔之後,我們再來看看應該如何更新一個已經存在的文檔。其實在創建文檔時我們就提到過,使用PUT /<index>/_doc/<id>的方法就可以更新一個已存在的文檔。除此之外,我們還有另一種更新文檔的方法:

POST /<index>/_update/<_id>

這兩種更新有所不同。_doc方法是先刪除原有的文檔,再創建新的。而_update方法則是增量更新,它的更新過程是先檢索到文檔,然後運行指定腳本,最後重新索引。

還有一個區別就是_update方法支持使用腳本更新,默認的語言是painless,你可以通過參數lang來進行設置。在請求參數方面,_update相較於_doc多了以下幾個參數:

  • lang:指定腳本語言
  • retry_on_conflict:發生衝突時重試次數,默認是0
  • **_source**:設置為false,則不返回任何檢索字段
  • **_source_excludes**:指定要從檢索結果排除的source字段
  • **_source_includes**:指定要返回的檢索source字段

下面的一個例子是用腳本來更新文檔

curl -X POST "localhost:9200/test/_update/1?pretty" -H 'Content-Type: application/json' -d'
{
    "script" : {
        "source": "ctx._source.counter += params.count",
        "lang": "painless",
        "params" : {
            "count" : 4
        }
    }
}
'

Upsert

curl -X POST "localhost:9200/test/_update/1?pretty" -H 'Content-Type: application/json' -d'
{
    "script" : {
        "source": "ctx._source.counter += params.count",
        "lang": "painless",
        "params" : {
            "count" : 4
        }
    },
    "upsert" : {
        "counter" : 1
    }
}
'

當指定的文檔不存在時,可以使用upsert參數,創建一個新的文檔,而當指定的文檔存在時,該請求會執行script中的腳本。如果不想使用腳本,而只想新增/更新文檔的話,可以使用doc_as_upsert。

curl -X POST "localhost:9200/test/_update/1?pretty" -H 'Content-Type: application/json' -d'
{
    "doc" : {
        "name" : "new_name"
    },
    "doc_as_upsert" : true
}
'

update by query

這個API是用於批量更新檢索出的文檔的,具體可以通過一個例子來了解。

curl -X POST "localhost:9200/twitter/_update_by_query?pretty" -H 'Content-Type: application/json' -d'
{
  "script": {
    "source": "ctx._source.likes++",
    "lang": "painless"
  },
  "query": {
    "term": {
      "user": "kimchy"
    }
  }
}
'

獲取文檔

ES獲取文檔用的是GET API,請求的格式是:

GET /<index>/_doc/<_id>

它會返迴文檔的數據和一些元數據,如果你只想要文檔的內容而不需要元數據時,可以使用

GET /<index>/_source/<_id>

請求參數

獲取文檔的有幾個請求參數之前已經提到過,這裏不再贅述,它們分別是:

  • refresh
  • routing
  • **_source**
  • **_source_excludes**
  • **_source_includes**
  • version
  • version_type

而還有一些之前沒提到過的參數,我們來具體看一下

  • preference:用來 指定執行請求的node或shard,如果設置為_local,則會優先在本地的分片執行
  • realtime:如果設置為true,則請求是實時的而不是近實時。默認是true
  • stored_fields:返回指定的字段中,store為true的字段

mget

mget是批量獲取的方法之一,請求的格式有兩種:

  • GET /_mget
  • GET /<index>/_mget

第一種是在請求體中寫index。第二種是把index放到url中,不過這種方式可能會觸發ES的安全檢查。

mget的請求參數和get相同,只是需要在請求體中指定doc的相關檢索條件

request

GET /_mget
{
    "docs" : [
        {
            "_index" : "jackey",
            "_id" : "1"
        },
        {
            "_index" : "jackey",
            "_id" : "2"
        }
    ]
}

response

{
  "docs" : [
    {
      "_index" : "jackey",
      "_type" : "_doc",
      "_id" : "1",
      "_version" : 5,
      "_seq_no" : 6,
      "_primary_term" : 1,
      "found" : true,
      "_source" : {
        "user" : "ja",
        "tool" : "ES",
        "message" : "qwer"
      }
    },
    {
      "_index" : "jackey",
      "_type" : "_doc",
      "_id" : "2",
      "_version" : 1,
      "_seq_no" : 2,
      "_primary_term" : 1,
      "found" : true,
      "_source" : {
        "user" : "zhe",
        "post_date" : "2019-11-15T14:12:12",
        "message" : "learning Elasticsearch"
      }
    }
  ]
}

刪除文檔

CURD操作只剩下最後一個D了,下面我們就一起來看看ES中如何刪除一個文檔。

刪除指定id使用的請求是

DELETE /<index>/_doc/<_id>

在併發量比較大的情況下,我們在刪除時通常會指定版本,以確定刪除的文檔是我們真正想要刪除的文檔。刪除請求的參數我們在之前也都介紹過,想要具體了解的同學可以直接查看。

delete by query

類似於update,delete也有一個delete by query的API。

POST /<index>/_delete_by_query

它也是要先按照條件來查詢匹配的文檔,然後刪除這些文檔。在執行查詢之前,Elasticsearch會先為指定索引做一個快照,如果在執行刪除過程中,要索引發生改變,則會導致操作衝突,同時返回刪除失敗。

如果刪除的文檔比較多,也可以使這個請求異步執行,只需要設置wait_for_completion=false即可。

這個API的refresh與delete API的refresh參數有所不同,delete中的refresh參數是設置操作是否立即可見,即只刷新一個分片,而這個API中的refresh參數則是需要刷新受影響的所有分片。

Bulk API

最後,我們再來介紹一種特殊的API,批量操作的API。它支持兩種寫法,可以將索引名寫到url中,也可以寫到請求體中。

  • POST /_bulk

  • POST /<index>/_bulk

在這個請求中,你可以任意使用之前的CRUD請求的組合。

curl -X POST "localhost:9200/_bulk?pretty" -H 'Content-Type: application/json' -d'
{ "index" : { "_index" : "test", "_id" : "1" } }
{ "field1" : "value1" }
{ "delete" : { "_index" : "test", "_id" : "2" } }
{ "create" : { "_index" : "test", "_id" : "3" } }
{ "field1" : "value3" }
{ "update" : {"_id" : "1", "_index" : "test"} }
{ "doc" : {"field2" : "value2"} }
'

請求體中使用的語法是newline delimited JSON(NDJSON)。具體怎麼用呢?其實我們在上面的例子中已經有所展現了,對於index或create這樣的請求,如果請求本身是有包體的,那麼用換行符來表示下面的內容與子請求分隔,即為包體的開始。

例如上面例子中的index請求,它的包體就是{ “field1” : “value1” },所以它會在index請求的下一行出現。

對於批量執行操作來說,單條操作失敗並不會影響其他操作,而最終每條操作的結果也都會返回。

上面的例子執行完之後,我們得到的結果應該是

{
   "took": 30,
   "errors": false,
   "items": [
      {
         "index": {
            "_index": "test",
            "_type": "_doc",
            "_id": "1",
            "_version": 1,
            "result": "created",
            "_shards": {
               "total": 2,
               "successful": 1,
               "failed": 0
            },
            "status": 201,
            "_seq_no" : 0,
            "_primary_term": 1
         }
      },
      {
         "delete": {
            "_index": "test",
            "_type": "_doc",
            "_id": "2",
            "_version": 1,
            "result": "not_found",
            "_shards": {
               "total": 2,
               "successful": 1,
               "failed": 0
            },
            "status": 404,
            "_seq_no" : 1,
            "_primary_term" : 2
         }
      },
      {
         "create": {
            "_index": "test",
            "_type": "_doc",
            "_id": "3",
            "_version": 1,
            "result": "created",
            "_shards": {
               "total": 2,
               "successful": 1,
               "failed": 0
            },
            "status": 201,
            "_seq_no" : 2,
            "_primary_term" : 3
         }
      },
      {
         "update": {
            "_index": "test",
            "_type": "_doc",
            "_id": "1",
            "_version": 2,
            "result": "updated",
            "_shards": {
                "total": 2,
                "successful": 1,
                "failed": 0
            },
            "status": 200,
            "_seq_no" : 3,
            "_primary_term" : 4
         }
      }
   ]
}

批量操作的執行過程相比多次單個操作而言,在性能上會有一定的提升。但同時也會有一定的風險,所以我們在使用的時候要非常的謹慎。

總結

本文我們先介紹了文檔的基本概念和文檔的元數據。接着又介紹了文檔的CRUD操作和Bulk API。相信看完文章你對Elasticsearch的文檔也會有一定的了解。那最後就請你啟動你的Elasticsearch,然後親自動手試一試這些操作,看看各種請求的參數究竟有什麼作用。相信親手實驗過一遍之後你會對這些API有更深的印象。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整
Java併發之volatile關鍵字

引言

說到多線程,我覺得我們最重要的是要理解一個臨界區概念。

舉個例子,一個班上1個女孩子(臨界區),49個男孩子(線程),男孩子的目標就是這一個女孩子,就是會有競爭關係(線程安全問題)。推廣到實際場景,例如對一個數相加或者相減等等情形,因為操作對象就只有一個,在多線程環境下,就會產生線程安全問題。理解臨界區概念,我們對多線程問題可以有一個好意識。

Jav內存模型(JMM)

談到多線程就應該了解一下Java內存模型(JMM)的抽象示意圖.下圖:

線程A和線程B執行的是時候,會去讀取共享變量(臨界區),然後各自拷貝一份回到自己的本地內存,執行後續操作。
JMM模型是一種規範,就像Java的接口一樣。JMM會涉及到三個問題:原子性,可見性,有序性。
所謂原子性。就是說一個線程的執行會不會被其他線程影響的。他是不可中斷的。舉個例子:

int i=1

這個語句在Jmm中就是原子性的。無論是一個線程執行還是多個線程執行這個語句,讀出來的i就是等於1。那什麼是非原子性呢,按道理如果Java的代碼都是原子性,應該就不會有線程問題了啊。其實JMM這是規定某些語句是原子性罷了。舉個非原子性例子:

i ++;

這個操作就不是原子性的了。因為他就是包含了三個操作:第一讀取i的值,第二將i加上1,第三將結果賦值回來給i,更新i的值。
所謂可見性。可見性表示如果一個值在線程A修改了,線程B就會馬上知道這個結果。
所謂有序性。所謂有序性值的是語意的有序性。就是說代碼順序可能會發生變化。因為有一個指令重排機制。所謂指令重排,他會改變代碼執行順序,為了讓cpu執行效率更高。為了防止重排序出錯,JMM有個happen-before規則,這個規則限制了那些語句執行在前,那些語句執行在後。
Happen-before:
程序順序原則:一個線程內保證語義的串行性
volatile原則:volatile變量的寫發生在讀之前
鎖規則:先加鎖再解鎖
傳遞性:a先於b,b先於c,則a必定先於c
線程的start方法先於他的每一個操作
線程所有的操作先於線程的終結
對象的構造函數執行、結束先於finalize()方法。

volatile

進入正題,volatile可以保證變量(臨界區)的可見性以及有序性,但是不能保證原子性。舉個例子:

public class VolatileTest implements Runnable{
    private static VolatileTest volatileTest = new VolatileTest();
    private  static volatile int i= 0;
    public static void main(String[] args) throws InterruptedException {
        for (int j = 0; j < 20; j++) {
            Thread a = new Thread(new VolatileTest());
            Thread b = new Thread(new VolatileTest());
            a.start();b.start();
            a.join();b.join();
            System.out.print(i+"&&");
        }

    }
    
    @Override
    public void run() {
        for (int j = 0; j < 1000; j++) {
            i++;
        }
    }

}

// 輸出結果
// 2000&&4000&&5852&&7852&&9852&&11852&&13655&&15655&&17655&&19655&&21306     
//&&22566&&24566&&26189&&28189&&30189&&32189&&34189&&36189&&38089&&

有結果看到有問題,雖然i已經添加了volatile關鍵字,說明volatile關鍵字不能保證i++的原子性。

那什麼場景適合使用volatile關鍵字

  1. 輕量級的“讀-寫鎖”策略
private volatile int value;
public int getValue(){ return value;}
public synchronized void doubleValue(){ value = value*value; }

2.單例模式(雙檢查鎖機制

private volatile static Singleton instace;   
public static Singleton getInstance(){  // 沒有使用同步方法,而是同步方法塊
    //第一次null檢查 ,利用volatile的線程間可見性,不需要加鎖,性能提高    
    if(instance == null){            
        synchronized(Singleton.class) {    //鎖住類對象,阻塞其他線程
            //第二次null檢查,以保證不會創建重複的實例       
            if(instance == null){       
                instance = new Singleton(); // 禁止重排序
            }  
        }           
    }  
    return instance;

參考

《現代操作系統(第三版)中文版》
《實戰Java高併發程序設計》
《Java併發編程的藝術》

如果我的文章幫助到您,可以關注我的微信公眾號,第一時間分享文章給您

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

將Swagger2文檔導出為HTML或markdown等格式離線閱讀

網上有很多《使用swagger2構建API文檔》的文章,該文檔是一個在線文檔,需要使用HTTP訪問。但是在我們日常使用swagger接口文檔的時候,有的時候需要接口文檔離線訪問,如將文檔導出為html、markdown格式。又或者我們不希望應用系統與swagger接口文檔使用同一個服務,而是導出HTML之後單獨部署,這樣做保證了對接口文檔的訪問不影響業務系統,也一定程度提高了接口文檔的安全性。核心的實現過程就是:

  • 在swagger2接口文檔所在的應用內,利用swagger2markup將接口文檔導出為adoc文件,也可以導出markdown文件。
  • 然後將adoc文件轉換為靜態的html格式,可以將html發布到nginx或者其他的web應用容器,提供訪問(本文不會講html靜態部署,只講HTML導出)。

注意:adoc是一種文件格式,不是我的筆誤。不是doc文件也不是docx文件。

一、maven依賴類庫

在已經集成了swagger2的應用內,通過maven坐標引入相關依賴類庫,pom.xml代碼如下:

<dependency>
    <groupId>io.github.swagger2markup</groupId>
    <artifactId>swagger2markup</artifactId>
    <version>1.3.1</version>
</dependency>
<dependency>
    <groupId>io.swagger</groupId>
    <artifactId>swagger-core</artifactId>
    <version>1.5.16</version>
</dependency>
<dependency>
    <groupId>io.swagger</groupId>
    <artifactId>swagger-models</artifactId>
    <version>1.5.16</version>
</dependency>

swagger2markup用於將swagger2在線接口文檔導出為html,markdown,adoc等格式文檔,用於靜態部署或離線閱讀。其中第一個maven坐標是必須的。后兩個maven坐標,當你在執行後面的代碼過程中報下圖中的ERROR,或者有的類無法import的時候使用。

產生異常的原因已經有人在github的issues上給出解釋了:當你使用swagger-core版本大於等於1.5.11,並且swagger-models版本小於1.5.11就會有異常發生。所以我們顯式的引入這兩個jar,替換掉swagger2默認引入的這兩個jar。

二、生成adoc格式文件

下面的代碼是通過編碼方式實現的生成adoc格式文件的方式

@RunWith(SpringRunner.class)
@SpringBootTest(webEnvironment = SpringBootTest.WebEnvironment.DEFINED_PORT)
public class DemoApplicationTests {
    @Test
    public void generateAsciiDocs() throws Exception {
        //    輸出Ascii格式
        Swagger2MarkupConfig config = new Swagger2MarkupConfigBuilder()
                .withMarkupLanguage(MarkupLanguage.ASCIIDOC) //設置生成格式
                .withOutputLanguage(Language.ZH)  //設置語言中文還是其他語言
                .withPathsGroupedBy(GroupBy.TAGS)
                .withGeneratedExamples()
                .withoutInlineSchema()
                .build();

        Swagger2MarkupConverter.from(new URL("http://localhost:8888/v2/api-docs"))
                .withConfig(config)
                .build()
                .toFile(Paths.get("src/main/resources/docs/asciidoc"));
    }
}
  • 使用RunWith註解和SpringBootTest註解,啟動應用服務容器。 SpringBootTest.WebEnvironment.DEFINED_PORT表示使用application.yml定義的端口,而不是隨機使用一個端口進行測試,這很重要。
  • Swagger2MarkupConfig 是輸出文件的配置,如文件的格式和文件中的自然語言等
  • Swagger2MarkupConverter的from表示哪一個HTTP服務作為資源導出的源頭(JSON格式),可以自己訪問試一下這個鏈接。8888是我的服務端口,需要根據你自己的應用配置修改。
  • toFile表示將導出文件存放的位置,不用加後綴名。也可以使用toFolder表示文件導出存放的路徑。二者區別在於使用toFolder導出為文件目錄下按標籤TAGS分類的多個文件,使用toFile是導出一個文件(toFolder多個文件的合集)。
@Test
public void generateMarkdownDocsToFile() throws Exception {
    //    輸出Markdown到單文件
    Swagger2MarkupConfig config = new Swagger2MarkupConfigBuilder()
            .withMarkupLanguage(MarkupLanguage.MARKDOWN)
            .withOutputLanguage(Language.ZH)
            .withPathsGroupedBy(GroupBy.TAGS)
            .withGeneratedExamples()
            .withoutInlineSchema()
            .build();

    Swagger2MarkupConverter.from(new URL("http://localhost:8888/v2/api-docs"))
            .withConfig(config)
            .build()
            .toFile(Paths.get("src/main/resources/docs/markdown"));
}

上面的這一段代碼是生成markdown格式接口文件的代碼。執行上面的2段單元測試代碼,就可以生產對應格式的接口文件。

還有一種方式是通過maven插件的方式,生成adoc和markdown格式的接口文件。筆者不常使用這種方式,沒有使用代碼生成的方式配置靈活,很多配置都放到pom.xml感覺很臃腫。但還是介紹一下,首先配置maven插件swagger2markup-maven-plugin。

<plugin>
    <groupId>io.github.swagger2markup</groupId>
    <artifactId>swagger2markup-maven-plugin</artifactId>
    <version>1.3.1</version>
    <configuration>
        <swaggerInput>http://localhost:8888/v2/api-docs</swaggerInput><!---swagger-api-json路徑-->
        <outputDir>src/main/resources/docs/asciidoc</outputDir><!---生成路徑-->
        <config>
            <swagger2markup.markupLanguage>ASCIIDOC</swagger2markup.markupLanguage><!--生成格式-->
        </config>
    </configuration>
</plugin>

然後運行插件就可以了,如下圖:

三、通過maven插件生成HTML文檔

<plugin>
    <groupId>org.asciidoctor</groupId>
    <artifactId>asciidoctor-maven-plugin</artifactId>
    <version>1.5.6</version>
    <configuration>
         <!--asciidoc文件目錄-->
        <sourceDirectory>src/main/resources/docs</sourceDirectory>
        <!---生成html的路徑-->
        <outputDirectory>src/main/resources/html</outputDirectory>
        <backend>html</backend>
        <sourceHighlighter>coderay</sourceHighlighter>
        <attributes>
            <!--導航欄在左-->
            <toc>left</toc>
            <!--显示層級數-->
            <!--<toclevels>3</toclevels>-->
            <!--自動打数字序號-->
            <sectnums>true</sectnums>
        </attributes>
    </configuration>
</plugin>

adoc的sourceDirectory路徑必須和第三小節中生成的adoc文件路徑一致。然後按照下圖方式運行插件。

HTMl接口文檔显示的效果如下,有了HTML接口文檔你想轉成其他各種格式的文檔就太方便了,有很多工具可以使用。這裏就不一一介紹了。

期待您的關注

  • 向您推薦博主的系列文檔:
  • 本文轉載註明出處(必須帶連接,不能只轉文字):。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

科大訊飛研發的全球中文學習平台上線

  隨着中國國際影響力的日益提升,漢語學習的需求與日俱增,為此,教育部、國家語委在《國家語言文字事業“十三五”發展規劃》中明確提出要“建設適應面廣、影響力大、權威性強的全球中文學習網絡平台”。10 月 25 日,在教育部、國家語委的指導下,由科大訊飛研發的全球中文學習平台正式上線。

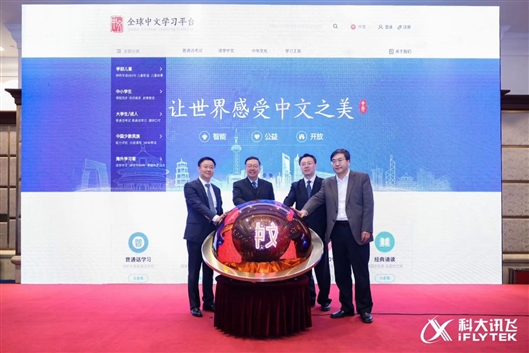
  該平台上線發布儀式在京舉行。教育部副部長、國家語委主任田學軍,北京市人民政府副秘書長韓耕、科大訊飛股份有限公司董事長劉慶峰和人民教育出版社社長黃強共同為平台發布舉行了啟動儀式,200 多位中外嘉賓見證了全球中文學習平台(www.chinese-learning.cn)的正式上線。

  針對海外學習者的“譯學中文”模塊,學習者可以通過語音或文本輸入其母語內容,實時翻譯出中文並自動分句。學習者學習每個語句的標準音並錄音跟讀,系統會實時反饋評價,指出發音問題;針對錯誤字詞,可以反覆學習,直到掌握正確中文發音。

  這是科大訊飛承建國家語委的又一個重大項目!2004 年,科大訊飛承擔了國家語委“十五”重點科研項目“智能語音技術在普通話輔助學習中的應用研究”;2016 年,承擔國家語委“十三五”重大科研項目“智能語音及人工智能技術在語言學習中的應用研究”。目前,上述兩大項目均已成功落地,並取得了良好的社會效益。

  全球中文學習平台,匯聚各類中文學習資源,以更好地為廣大中文學習者提供優質服務為宗旨,於 2016 年底啟動建設,是落實《國家語言文字事業“十三五”發展規劃》相關任務要求的具體舉措。在教育部、國家語委與科大訊飛的共同努力下,歷經兩年多時間的不斷完善和改進,平台建設取得积極成效,相關基礎研究取得重要進展,為平台提供了堅實技術保障。其中智能語音、智能寫作和批改等關鍵技術研究成果在中小學語言能力評價、少數民族國家通用語言學習等方面得到實際應用。平台示範功能已分別在“砥礪奮進的五年”大型成就展、第二屆語博會、第十二屆孔子學院大會等不同場合進行展示,得到了各方好評。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

Class文件結構全面解析(下)

接上回書

書接,分享了Class文件的主要構成,同時也詳細分析了魔數、次版本號、主版本號、常量池集合、訪問標誌的構造,接下來我們就繼續學習。

歡迎關注微信公眾號:萬貓學社,每周一分享Java技術乾貨。

類索引和父類索引

類索引(this_class)和父類索引(super_class)都是一個u2類型的數據,類索引用於確定這個類的全限定名,父類索引用於確定這個類的父類全限定名。由於java語言不允許多重繼承,所以父類索引只有一個。

類索引和父類索引各自指向常量池中類型為CONSTANT_Class_info的類描述符,再通過類描述符中的索引值找到常量池中類型為CONSTANT_Utf8_info的字符串。再來看一下之前的Class文件例子:

歡迎關注微信公眾號:萬貓學社,每周一分享Java技術乾貨。

結合之前javap分析出來的常量池內容:

   #3 = Class         #17        // OneMoreStudy
   #4 = Class         #18        // java/lang/Object
  #17 = Utf8          OneMoreStudy
  #18 = Utf8          java/lang/Object

類索引為0x0003,去常量池裡找索引為3的類描述符,類描述符中的索引為17,再去找索引為17的字符串,就是“OneMoreStudy”。

父類索引為0x0004,去常量池裡找索引為4的類描述符,類描述符中的索引為18,再去常量池裡找索引為18的字符串,就是“java/lang/Object”。

歡迎關注微信公眾號:萬貓學社,每周一分享Java技術乾貨。

接口索引集合

接口索引集合(interface)是一組u2類型的數據的集合,由於java語言允許實現多個接口,所以接口索引也有多個,它們按照implements語句后的接口順序從左到右依次排列在接口索引集合中。接口索引集合的第一項數據是接口集合計數值(interfaces_count),表示有多少接口索引。如果該類沒有實現任何接口,那麼該計數值為0,後面的接口索引表不佔任何字節。之前的例子OneMoreStudy類沒有實現任何接口,所以接口集合計數值就是0,如下圖:

歡迎關注微信公眾號:萬貓學社,每周一分享Java技術乾貨。

字段表集合

字段表(field_info)是用來描述接口或類中聲明的變量。包括類級變量(靜態變量)和實例級變量(成員變量),但是不包括在方法內部聲明的局部變量。具體結構如下錶:

類型 名稱 數量 描述
u2 access_flags 1 字段的訪問標誌
u2 name_index 1 字段的簡單名稱索引
u2 descriptor_index 1 字段的描述符索引
u2 attributes_count 1 字段的屬性計數值
attribute_info attributes attributes_count 字段的屬性

字段表中的access_flags,和類的access_flags是非常類似的,但是標識和含義是不一樣的。具體如下錶:

標誌名稱 標誌值 含義
ACC_PUBLIC 0x0001 字段是否public
ACC_PRIVATE 0x0002 字段是否private
ACC_PROTECTED 0x0004 字段是否protected
ACC_STATIC 0x0008 字段是否static
ACC_FINAL 0x0010 字段是否為final
ACC_VOLATILE 0x0040 字段是否volatile
ACC_TRANSIENT 0x0080 字段是否transient
ACC_SYNTHETIC 0x1000 字段是否由編譯器自動產生的
ACC_ENUM 0x4000 字段是否enum

歡迎關注微信公眾號:萬貓學社,每周一分享Java技術乾貨。

這裏提到了簡單名稱、描述符,和全限定名有什麼區別呢?稍微說一下。

簡單名稱是沒有類型和參數修飾的方法或字段名稱,比如OneMoreStudy類中的number字段和plusOne()方法的簡單名稱分別是“number”和“plusOne”。

全限定名是把類全名中的“.”替換成“/”就可以了,比如java.lang.Object類的全限定名就是“java/lang/Object”。

描述符是用來描述字段的數據類型、方法的參數列表(包括數量、類型以及順序)和返回值。基礎數據類型和無返回的void類型都有一個大寫字母表示,對象類型用字符L加對象的全限定名來表示,如下錶:

標識字符 含義
B 基本類型byte
C 基本類型char
D 基本類型double
F 基本類型float
I 基本類型int
J 基本類型long
S 基本類型short
Z 基本類型boolean
V 特殊類型void
L 對象類型 如 Ljava/lang/Object

對於數組類型,每一維度使用一個前置的“[”字符來描述,比如java.lang.Object[][]的二維數據,就是“[[Ljava/lang/Object”。在描述方法時,按照先參數列表,后返回值的順序描述,參數列表按照嚴格順序放在“()”值中,比如boolean equals(Object anObject),就是“(Ljava/lang/Object)B”。

歡迎關注微信公眾號:萬貓學社,每周一分享Java技術乾貨。

再來看一下之前的Class文件例子:

OneMoreStudy類中只有一個字段number,所以字段計數值為0x0001。字段number只被private修飾,沒有其他修飾,所以字段的訪問標誌位為0x0002。字段的簡單名稱索引是0x0005,去常量池中找索引為5的字符串,為“number”。字段的描述符索引為0x0006,去常量池中找索引為6的字符串,為“I”,是基本類型int。以下是常量池相關內容:

   #5 = Utf8          number
   #6 = Utf8          I

字段number的屬性計數值為0x0000,也就是沒有需要額外描述的信息。

字段表集合中不會列出從父類或者父接口中繼承而來的字段,但有可能列出原版Java代碼中沒有的字段,比如在內部類中為了保持對外部類的訪問性,會自動添加指向外部類實例的字段。

歡迎關注微信公眾號:萬貓學社,每周一分享Java技術乾貨。

方法表集合

方法表的結構和字段表的是一樣的,也是依次包括了訪問標誌(access_flags)、名稱索引(name_index)、描述符索引(descriptor_index)和屬性表集合(attributes)。具體如下錶:

類型 名稱 數量 描述
u2 access_flags 1 方法的訪問標誌
u2 name_index 1 方法的簡單名稱索引
u2 descriptor_index 1 方法的描述符索引
u2 attributes_count 1 方法的屬性計數值
attribute_info attributes attributes_count 方法的屬性

對於方法的訪問標誌,所有標誌位和取值如下錶:

標誌名稱 標誌值 含義
ACC_PUBLIC 0x0001 方法是否public
ACC_PRIVATE 0x0002 方法是否private
ACC_PROTECTED 0x0004 方法是否protected
ACC_STATIC 0x0008 方法是否static
ACC_FINAL 0x0010 方法是否為final
ACC_SYNCHRONIZED 0x0020 方法是否sychronized
ACC_BRIDGE 0x0040 方法是否是由編譯器產生的橋接方法
ACC_VARARGS 0x0080 方法是否接受不定參數
ACC_NATIVE 0x0100 方法是否為native
ACC_ABSTRACT 0x0400 方法是否為abstract
ACC_STRICT 0x0800 方法是否為strictfp
ACC_SYNTHETIC 0x1000 方法是否由編譯器自動產生

方法中的Java代碼,經過編譯器編程成字節碼指令后,放在方法屬性表集合中一個名為“Code”的屬性里,後面會有更多分享。

歡迎關注微信公眾號:萬貓學社,每周一分享Java技術乾貨。

再來看一下之前的Class文件例子:

方法計算值為0x0003,表示集合中有兩個方法(編譯器自動添加的無參構造方法和源碼中的plusOne方法)。第一個方法的訪問標誌是0x0001,表示只有ACC_PUBLIC標誌為true。

名稱索引為0x0007,在常量池中為索引為7的字符串為“ ”,這就是編譯器自動添加的無參構造方法。描述符索引為0x0008,在常量池中為索引為7的字符串為“()V”,方法的屬性計數值為0x0001,表示該方法有1個屬性,屬性名稱索引為0x0009,在常量池中為索引為7的字符串為“Code”。以下是常量池相關內容:

   #7 = Utf8          <init>
   #8 = Utf8          ()V
   #9 = Utf8          Code

歡迎關注微信公眾號:萬貓學社,每周一分享Java技術乾貨。

屬性表集合

屬性表(attribute_info)在前面的分享中出現了幾次,在Class文件、字段表、方法表都可以有自己的屬性表集合,用來描述某些場景下特有的信息。

屬性表不在要求具有嚴格的順序,並且只要不與已有的屬性名重複,任何人實現的編譯器都可以寫入自己定義的屬性信息,Java虛擬機在運行時會忽略掉它不認識的屬性。

我總結了一些比較常見的屬性,如下錶:

屬性名稱 使用位置 含義
Code 方法表 Java代碼編譯成的字節碼指令
ConstantValue 字段表 final關鍵字定義的常量值
Exceptions 方法表 方法拋出的異常
InnerClasses 類文件 內部類列表
LineNumberTable Code屬性 Java源碼的行號與字節碼指定的對應關係
LocalVariableTable Code屬性 方法的局部變量描述
SourceFile 類文件 記錄源文件名稱

對於每個屬性,它的名稱都從常量池中引用一個CONSTANT_Utf8_info類型的常量,而屬性值的結構則是完全自定義的,只需要用一個u4類型來說明屬性值所佔的位數就可以了。具體結構如下:

類型 名稱 數量 含義
u2 attribute_name_index 1 屬性名稱索引
u2 attribute_length 1 屬性值所佔的位數
u1 info attribute_length 屬性值

歡迎關注微信公眾號:萬貓學社,每周一分享Java技術乾貨。

總結

Class文件主要由魔數、次版本號、主版本號、常量池集合、訪問標誌、類索引、父類索引、接口索引集合、字段表集合、方法表集合和屬性表集合組成。隨着JDK版本的不斷升級,Class文件結構也在不斷更新,學習之路,永不止步。

歡迎關注微信公眾號:萬貓學社,每周一分享Java技術乾貨。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※公開收購3c價格,不怕被賤賣!

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

大型科技團隊的管理

介紹了高效科技組織的特點及管理經驗,指出科技團隊的定位和使命在於支持業務、賦能業務、最終引領業務,同時,還介紹了面向未來的科技組織的特點及對管理者提出的能力要求。

內容來源 | LeaTech全球CTO領導力峰會宜信公司CTO 高級副總裁向江旭分享《大型科技團隊的管理》

主講人 | 宜信公司CTO 高級副總裁向江旭

實錄整理 | 宜信技術學院成芳

引言:11月16日,由51CTO旗下CTO訓練營品牌精心打造的LeaTech全球CTO領導力峰會在北京粵財JW萬豪酒店拉開序幕。作為CTO、技術VP、技術總監等技術管理者人群的高端社交圈,本屆峰會現場聚集了CTO訓練營歷屆校友、CTO導師,以及行業中的資深技術管理者。600多位與會嘉賓在現場充分交流了有關技術性視野、技術領導力、技術團隊組織建設等精彩話題的觀點與思考,藉助峰會這個線下平台,技術管理者們积極探索了更多商業可能,開拓管理視野,令自身領導力再上新台階。

本次峰會邀請到宜信公司CTO 高級副總裁向江旭先生,帶來主題為《大型科技團隊的管理》的分享,向江旭先生在分享中提到科技團隊的定位和使命在於支持業務、賦能業務、最終引領業務,同時,他還介紹了面向未來的科技組織的特點及對管理者提出的能力要求。

以下為本次演講的分享實錄。

各位朋友下午好,今天我分享的主題是《大型科技團隊的管理》,非常高興能跟大家分享一些關於大型科技團隊管理的經驗和觀察。

去年12月,我在另一個峰會的分享中提到經濟寒冬、金融寒冬,今年這個時候也開始進入冬季,但是不管外面的大環境如何,技術人/技術圈都非常幸運,在科技賦能的市場中,技術人總是被需要的,技術圈也總是熱情高漲的。我認為,關於技術團隊的管理經驗非常值得與大家一起分享和交流。

一、大型科技團隊的特點及定位

大型科技團隊一般都有以下幾個特點:

  • 一定規模。顧名思義,談到大型科技團隊首先想到的特點肯定是團隊成員眾多。
  • 地域分佈廣。科技團隊的成員可能分佈在不同的地方。
  • 團隊背景多元。這種多元包括兩個層面的含義:一是角色背景多元,有的成員甚至不是做技術(這裏特指軟件研發)的,而是從其他行業轉過來的,比如行業數據分析師等角色。二是團隊成員的種族、國家背景多元。

一定規模、團隊背景多元化、分佈在不同地域等特點,使得大型科技團隊在管理上面臨着非常大的挑戰。

1.1 大型科技公司的科技團隊組織架構

上圖是一些大家耳熟能詳的漫畫,介紹了幾種典型的科技公司的科技團隊架構形式。

  • “Google式團隊架構”:最上面是兩個創始人和一個CEO,下面是部門負責人,其特點是下一級有多個彙報對象,這是谷歌的內部架構和管理方式,從一個層面代表了某個歷史階段科技組織的團隊構造。
  • “Amazon式團隊架構”:典型的層級式管理,逐級彙報。
  • “Oracle式團隊架構”:特點是有一個專門的法務團隊,因為Oracle收購了很多公司,某種程度上它是一個法務或銷售導向的公司。
  • “Facebook式團隊架構”:Facebook的團隊結構和它的業務一樣,是社交網絡形式的網狀結構。
  • “Apple式團隊架構”:(這是一張比較早期的圖)其特點是最核心的靈魂人物的觸角深入到公司的方方面面,事無巨細都是他在親自主導。
  • “Microsoft式團隊結構”:最後這張也是之前的圖,代表的是我服務過的公司-微軟。三大版塊部門沒有交集,很深的部門牆,互相之間存在比較激烈的內部鬥爭。

由此可見,大型科技公司的文化基因決定了其科技團隊的組織架構形式,而科技組織架構的設計和管理很大程度上決定了組織的效能。

1.2 科技團隊的使命和定位

在討論科技團隊的管理之前,有一個很重要的前提,要知道科技團隊的使命和定位是什麼。

很多非科技驅動的公司,比如銀行、保險公司、地產公司等,都在計劃或嘗試轉型成為一家科技公司。我認為在這樣的背景下,科技從業人員反而應該更清楚自己的定位。

1)支持業務

首先我們是支持業務的,要把業務放在最核心的位置,如果公司是靠產品和服務生存的,業務沒做好,科技也不一定能做好。當然公司類型不一樣,不能一概而論。比如純科技公司微軟,產品和服務本身就是技術,技術的好壞決定了公司業務的好壞。

2)賦能業務

科技團隊通過開發一些工具,幫助業務、銷售等部門實現業務流程信息化、智能化,使得業務流轉的過程更為暢通和友好。甚至更進一步,開發一個好的技術平台,使得生態圈、合作夥伴、第三方公司能夠在平台上發展業務、共建生態,這時科技團隊就起到了賦能業務的作用。

3)引領業務

科技團隊還可以通過技術創新、產品創新來拓展新的業務領域,催生新的業務模式,增加新的收入來源,成為引領業務的力量。

這三點是相輔相成的,支持業務、賦能業務,最後引領業務,不論是在技術驅動的公司,還是在業務驅動的公司,技術團隊的使命和定位都是如此。

1.3 技術和業務的關係

定位決定地位,業務發展是終極目標,當面臨整體技術戰略與商業戰略衝突、技術實施節點選擇、技術與業務路徑匹配等問題時,技術管理者可以從以下方面進行思考。

1)解決技術戰略與商業戰略的衝突。

技術和業務除了相輔相成的關係外,還存在一定的衝突。其實技術和業務的衝突在大家平時的工作中經常見到,比如業務同事着急上線一個功能來做活動;而技術覺得要達到同樣的目的,我們可能需要好的設計和架構,而不是簡單做一個臨時補丁式的功能,這就是很常見的技術和業務的衝突。

雖然技術負責人要對未來中長期的戰略布局保持持續思考,但這取決於公司的大小、規模和階段。如果是初創公司,首要任務是生存,那麼業務需求是最高優先級,首先要考慮解決系統不穩定、安全或其他問題;但對於有一定體量的企業,公司業務已經發展到一定階段,技術團隊也有一定的規模,當存在業務需求和技術戰略的衝突時,在滿足最緊迫的業務需求的同時,將一定精力投入到基礎技術研發中去,必須要做中長期的項目預研,做一些底層、甚至風險較高的研究。

2)技術變革的實施節點

我們永遠在高速公路上奔跑,一邊行駛一邊換輪子或換部件的事情一直在發生。技術重構、技術變革、技術債務償還的時機和節點和對業務產生的影響,是我們面臨的又一個挑戰,也是需要我們長期考慮的問題。

什麼節點選擇什麼樣的技術?技術負責人具體把握新技術引入節點,其實難度很大。如果新技術距離實現商用價值僅有一年時間,那麼必須要進行布局,申請預算,建立團隊推進;如果新技術商業化已經迫在眉睫,競爭對手已經在布局了,那麼採取的措施就不是從頭做起,更好的應對方式可能是進行併購或資本運作。

3)技術與業務路徑匹配

新技術來臨,對業務的影響和衝擊會分短、中、長期,有的技術在短期內對新的業態有幫助,有的技術需要一個比較長的周期才會對業務產生影響。這時技術領導人要評估技術本身,並將其與業務的戰略路徑進行匹配,如果對長期業務有幫助,新技術仍然要引入,只是選擇時間點、投入範圍等可能會不一樣。

同時,在引入新技術進行技術創新時,還要注意新技術對當前業務產生的影響。舉個例子,宜信是一家金融科技公司,有自己的催收部門,我們一方面通過規範催收人員的行為來進行催收,一方面自己研發催收機器人。催收機器人的出現意味着部分催收人員的工作將會被替代,同時,機器人的特點之一是沒有情緒,它會按照程序設定禮貌地和用戶溝通,這就會在一定程度對催收效果和業務產生影響。因此我們還要考慮在哪個環節使用機器人這個技術,帶來的效果會更好。這也是技術和業務相輔相成又存在矛盾衝突關係的體現。

1.4 科技戰略

對於大型科技團隊而言,科技戰略思維也非常重要。舉幾個例子。

舉例提到的是我工作過的幾家公司,它們在不同的時間點做了一些不同的戰略調整。

很多年以前,在中國90%的Windows都不是正版的,於是微軟內部提出一個計劃,希望Windows在中國免費。這個計劃現在看起來非常簡單,也很容易理解,正版Windows免費帶來的好處顯而易見:它是一個非常好的終端用戶觸點、可以獲取更多用戶,可以基於這些用戶數據做數據分析和精準營銷等。但是當時微軟Windows的老大極力反對這件事,他認為這會影響Windows的營收,因此這個計劃最終沒有實行。這就是戰略思維的問題,如果不是在中國本地親身體驗這個環境和市場,可能做出的戰略決策就不一定是準確的,帶來的結果可能是痛失更大的發展機會。

微軟後來的雲戰略轉型是成功的,而移動轉型卻是失敗的。移動轉型時期,微軟收購諾基亞旗下的大部分手機業務,並基於Windows自研出一個Windows操作系統放在手機硬件上。因為微軟覺得沒有推出自己的手機這是一個缺憾,還認為佔領移動終端必須基於Windows,因此作出這樣的決策,結果以失敗告終。Windows使微軟一度成為桌面系統垄斷的贏家,也使得微軟在移動轉型失敗,成為下一步發展的絆腳石,可謂是成也Windows,敗也Windows。

再看蘇寧,蘇寧受到阿里巴巴、京東等電商的衝擊,痛下決心必須做電商,它採取的戰略是結合自己線下門店的優勢做O2O智慧門戶,實行線上下單、線下體驗、送貨到家,這種全渠道、全觸點的用戶交互與服務形式,使得蘇寧成為“中國傳統行業数字化轉型互聯網”為數不多的成功案例之一。

現在金融行業正處於嚴監管的環境,金融公司該何去何從?在這裏分享一些我的看法。

縱觀改革開放以來的歷史,每個行業在開始初期都是開放的,任何人都可以參与進來,魚龍混雜,一旦行業出現亂象,就會有監管介入,那些能力不強的、不合規的會被淘汰,等到監管后再開放、行業再成熟時,最後存活下來的才能健康發展。金融行業也是如此。

科技同仁不僅要埋頭做好自己的工作,也要抬頭看看歷史和未來,思考我們身處的這個行業,我們從事的科技工作對公司、對行業的作用是什麼?行業未來的發展趨勢是什麼,這對我們未來的職業發展也有幫助。

二、大型科技團隊的管理實踐

2.1 成功科技組織的特點

無論是前面提到的國際科技巨頭,還是國內優秀的互聯網公司,成功的科技組織都具備一些共同的特點。

1)高效、敏捷

優秀的科技團隊一定是一個高效、敏捷的團隊,能夠快速響應用戶和市場的需求變化,快速上線產品、得到反饋、不斷迭代更新,滿足或超過用戶的預期。

2)商業思維

科技團隊一定要有商業頭腦、商業思維,因為無論是搭建系統,還是做APP,一定有用戶,我們需要真正洞察到用戶的痛點和問題,幫他們及時解決問題,給他們創造價值。

3)數據驅動

如果科技團隊的工作只圍繞產品經理提出的需求,未來的產品路線圖還不夠,一定要基於用戶反饋、市場反饋、日活、月活、留存、轉化等數據來驅動產品走向、技術走向。

4)變革創新

很多公司都在強調變革和創新,我認為這是科技團隊必須要打造的環境和氛圍,方式很多,比如組織各種各樣的黑客馬拉松、團隊之間的交流分享等。我們公司也在組織黑客馬拉松,每個月業務部門都有比較棘手或緊迫的項目,技術團隊與業務團隊聯合把這些業務痛點解決,成果馬上應用到業務環境中去。

2.2 績效管理

績效管理的機制在微軟實行了很多年,其強制5%、10%的淘汰機制,一直被人詬病,因為它使得很多團隊互相指責、互相拆台,有的員工為了績效“寧當雞頭不當鳳尾”,組織內形成不好的文化和結果。後來改成了5%、10%的獎勵,從懲罰後進者變成鼓勵先進者,取得的效果好很多。

2.3 溝通

溝通每天都在進行,比如各種大大小小的會議。我發現不管開多少會,高層領導的想法、思路並不一定能被所有同事理解,因為溝通方式、溝通渠道的原因,信息不能觸達到所有人,需要重複很多遍。

我們可以利用一些非正式場合或社交媒體來進行交流。比如我們公司有每月的CTO午餐會,抽籤的方式,各團隊都有機會可以坐下來跟我一起吃午餐,通過這種面對面的交流,我會向團隊成員提出一些我的看法,或者推薦一本書,他們會向我反饋當時的痛點、想法等。我覺得這是一種非常好的機制,大家能夠在一個寬鬆的環境下面對面地交流。記得以前在思科工作的時候,也有CEO早餐會,每個月過生日的員工可以跟CEO吃早餐,也是一種很好的溝通互動的方式。

2.4 團隊文化

團隊文化包含很多要素,我對這幾點的認同感比較深:主人翁意識、緊迫感、同理心。

2.5 技術決策

商業世界充滿了選擇和決策。作為一個技術決策人,有時很難做決定,難做決定就意味着拖延,這一點對於大型科技團隊的決策人來說是比較忌諱的,很多時候不在於你做的決策是對還是錯,而是在於你做不做決定。如果你是一個不敢做決定的人,帶領的團隊就會缺乏方向感,你做的決定就會受到團隊的質疑和挑戰。

有時候即使你做出了錯誤的決定,但大家一起努力執行的時候,可能可以逐步調整轉變從而達成正確的結果。技術管理人一定要懂得取捨,通過大腦計算,明確目標,了解關聯方,分析可選項和利弊,基於目標、數據和對未來的預期做出決策。

2.6 執行力

執行的時候要不忘初心,一步步地大處着眼、小處着手,小步快跑,快速迭代,及時反饋,及時調整,朝着設定的目標專心致志、心無旁騖。

2.7 終極目標

最後的終極目標是,希望科技團隊能夠做到比業務更懂業務,比用戶更懂用戶,讓技術本身變成公司核心的業務。我認為如果能做到科技團隊在公司起到了核心的作用,這才是永生的價值。

三、面向未來的科技組織

3.1 回顧微軟的3任CEO和3種組織

就微軟而言,同一家公司,文化和技術氛圍在不同階段是不一樣的。

第一個階段,CEO比爾蓋茨,技術為王,認為技術改變世界,代碼可以改變千萬人的生活。這一階段造就了好的產品,同時也存在一些負面影響,比如垄斷等。

第二個階段,CEO鮑爾默,業績為王,要求所有設備,包括手機、電視、車等,都跑到Windows上,還和海爾合作推出基於Windows的智能電視,當時所有跟Windows衝突的想法和計劃基本都被扼殺在搖籃里,這也導致公司錯失了很多發展的機會。

第三個階段,CEO納德拉,公司文化變得更加包容、強調同理心、開放透明,包括技術開源、提供雲服務、和蘋果/谷歌等競爭對手合作。這種開放包容的氛圍,讓微軟得以浴火重生。

3.2 面向未來的科技組織

面向未來的科技組織應該是什麼樣的?

1)跨界融合

不同背景的人,融合到一個跨界的氛圍和組織中,一起發力。

2)数字化轉型

傳統公司也在做数字化轉型,這時會引入很多科技人才,利用科技幫助公司完成轉型,並在行業實現快速發展。

3)全球共享、全球分佈

團隊組成全球化,來自不同國家、不同種族的人組成一個全球化的團隊。東南亞有一個集美團、滴滴、螞蟻金服為一體的公司,解決出行、支付、快遞的問題,這家公司有一個幾千人的科技團隊,團隊成員來自50多個種族,分佈在美國、新加坡、北京、印尼、印度等國家和地區。

4)技術引領

未來科技團隊不僅要做到賦能業務,還要能實現引領業務。

這樣的科技團隊需要跨界、全球化、複合型的領導人,只有既懂科技、又懂管理;既要懂業務,又懂行業的管理人才才能適合於領導面向未來的科技組織。

以上就是今天跟大家分享的全部內容,時間很短,主要介紹了一些在不同公司不同行業的大型科技團隊的管理經驗,希望大家在面向未來的科技組織中找到自己的定位,成為一個優秀的領導者。謝謝大家。

本文根據向江旭老師在LeaTech全球CTO領導力峰會上的分享內容整理所得,轉載請聯繫授權。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※3c收購,鏡頭 收購有可能以全新價回收嗎?

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※賣IPHONE,iPhone回收,舊換新!教你怎麼賣才划算?

Orleans 3.0 為我們帶來了什麼


原文:https://devblogs.microsoft.com/dotnet/orleans-3-0/

作者:Reuben Bond,Orleans首席軟件開發工程師

翻譯:艾心

這是一篇來自Orleans團隊的客座文章,Orleans是一個使用.NET創建分佈式應用的跨平台框架。獲取更多信息,請查看https://github.com/dotnet/orleans。

我們激動的宣布Orleans3.0的發布。自Orleans2.0以來,加入了大量的改進與修復,以及一些新特性。這些變化是由許多人在生產環境的大量場景中運行基於Orleans應用程序的經驗,以及全球Orleans社區的智慧和熱情推動的,他們致力於使代碼庫更好、更快、更靈活。非常感謝所有以各種方式為這個版本做出貢獻的人。

自Orleans 2.0以來的關鍵變化:

Orleans 2.0發佈於18個多月前,從那時起Orleans便取得了巨大的進步。以下是自Orleans 2.0以來的重大變化:

  • 分佈式ACID事務-多個Grains加入到一個事務中,不管他們的狀態存儲在哪裡
  • 一個新的調度器,在某些情況下,僅它就可以將性能提升30%以上
  • 一種基於Roslyn代碼分析的新的代碼生成器
  • 重寫集群成員以提升恢復速度
  • 聯合(Co-hosting)支持

還有很多其他的提升以及修復。

自從致力於開發Orleans2.0以來,團隊就建立了一套實現或者繼承某些功能的良性循環,包括通用主機、命名選項,在準備將這些功能好成為.NETCore的一部分之前與.NET團隊密切合作、提供反饋和改進“upstream”,在以後的版本中會切換到.NET版本附帶的最終實現。在開發Orleans 3.0期間,這個循環繼續着,在最終發布為.NET Core 3.0的一部分之前,Orleans 3.0.0-beta1使用了Bedrock代碼。類似的,TCP套接字連接對TLS的支持是作為Orleans 3.0的一部分實現的,並計劃成為.NET Core未來版本的一部分。我們把這種持續的合作視為是我們對更大的.NET生態系統的貢獻,這是真正的開源精神。

使用ASP.NET Bedrock替換網絡層

一段時間以來,社區和內部合作夥伴一直要求支持與TLS的安全通信。在3.0版本中,我們引入了TLS支持,可以通過Microsoft.Orleans.Connections.Security包獲取。有關更多信息,請查看TransportLayerSecurity範例。實現TLS支持之所以是一個重大任務要歸因於上一個版本中Orleans網絡層的實現方式:它並不容易適應使用SslStream的方式,而SslStream又是實現TLS最常用的方法。在TLS的推動下,我們着手重寫Orleans的網絡層。

Orleans 3.0使用了一個來自ASP.NET團隊倡議的基於Bedrock項目構建的網絡層替換了自己的整個網絡層,Bedrock旨在幫助開發者構建快速的、健壯的網絡客戶端和服務器。

ASP.NET團隊和Orleans團隊一同合作設計了同時支持網絡客戶端和服務端的抽象,這些抽象與傳輸無關,並且可以通過中間件實現定製化。這些抽象允許我們通過配置修改網絡,而不用修改內部的、特定於Orleans的網絡代碼。Orleans的TLS支持是作為Bedrock中間件實現的,我們的目的是使之通用,以便與.NET生態圈的其他人共享。

儘管這項工作是的動力是啟用TLS支持,但是在夜間負載測試中,我們看到了平均吞吐量提升了大約30%。

網絡層重寫還包括藉助使用MemoryPool<byte>替換我們的自定義緩存池,在進行這項修改時,序列化更多的使用到了Span<T>。有一些代碼路徑之前是依靠調用BlockingCollection<T>的專有線程進行阻塞,現在使用Channel<T>來異步傳輸消息。這將導致更少的專有線程佔用,同時將工作移動到了.NET線程池。

Orleans的核心連接協議自發布以來一直都是固定的。在Orleans3.0中,我們已經增加了通過協議協商(negotiation)逐步更新網絡層的支持。Orleans 3.0中添加的協議協商支持未來的功能增強,如定製核心序列化器,同時向後保持兼容性。新的網絡協議的一個優點是支持全雙工Silo到Silo的連接,而不是以前在Silo之間建立的單工連接對。協議版本可以通過ConnectionOptions.ProtocolVersion進行配置。

通過通用主機進行聯合託管

Orleans與其他框架共同進行聯合託管,如ASP.NETCore,得益於.NET通用主機,相同的進程中(使用聯合託管)現在要比以前容易多了。

下面是一個使用UseOrleans將Orleans和ASP.NETCore一起添加到主機的例子:

 1 var host = new HostBuilder()
 2   .ConfigureWebHostDefaults(webBuilder =>
 3   {
 4     // Configure ASP.NET Core
 5     webBuilder.UseStartup<Startup>();
 6   })
 7   .UseOrleans(siloBuilder =>
 8   {
 9     // Configure Orleans
10     siloBuilder.UseLocalHostClustering();
11   })
12   .ConfigureLogging(logging =>
13   {
14     /* Configure cross-cutting concerns such as logging */
15   })
16   .ConfigureServices(services =>
17   {
18     /* Configure shared services */
19   })
20   .UseConsoleLifetime()
21   .Build();
22 
23 // Start the host and wait for it to stop.
24 await host.RunAsync();

使用通過主機構建器,Orleans將與其他託管程序共享同一個服務提供者。這使得這些服務可以訪問Orleans。例如,一個開發者可以注入IClusterClient或者IGrainFactory到ASP.NETCore MVC Controller中,然後從MVC應用中直接調用Grains。

這個功能可以簡化你的部署拓撲或者向現有程序中額外添加功能。一些團隊內部使用聯合託管,通過ASP.NET Core健康檢查將Kubernetes活躍性和就緒性探針添加到其Orleans Silo中。

可靠性提高

得益於擴展了Gossip,集群現在可以更快的從失敗中恢復。在以前的Orleans版本中,Silo會向其他Silo發送成員Gossip信息,指示他們更新成員信息。現在Gossip消息包括集群成員的版本化、不可變快照。這樣可以縮短Silo加入或者離開集群的收斂時間(例如在更新、擴展或者失敗后),並減輕共享成員存儲上的爭用,從而加快集群轉換的速度。故障檢測也得到了改進,利用更多的診斷信息和改進功能以確保更快、更準確的檢測。故障檢測涉及集群中的Silo,他們相互監控,每個Silo會定期向其他Silo的子集發送健康探測。Silo和客戶端現在還主動與已聲明為已失效的Silo的連接斷開,它們將拒絕與此類Silo的連接。

現在,消息錯誤得到了更一致的處理,從而將錯誤提示信息傳播回調用者。這有助於開發者更快地發現錯誤。例如,當消息無法被完全序列化或者反序列化時,詳細的異常信息將會被返回到原始調用方。

可擴展性增強

現在,Streams可以有自定義的數據適配器,從而允許他們以任何格式提取數據。這使得開發人員更好的控制Streamitems在存儲中的表示方式。他還使Stream提供者可以控制如何寫入數據,從而允許Streams與老的系統和Orleans服務集成。

Grain擴展允許通過自己的通信接口附件新的組件,從而在運行時向Grain添加其他行為。例如,Orleans事務使用Grain擴展對用戶透明的向Grain中添加事務生命周期方法,如“準備”、“提交”和“中止”。Grain擴展現在也可用於Grain服務和系統目標。

現在,自定義事務狀態可以聲明其在事務中能夠扮演的角色。例如,將事務生命周期事件寫入服務總線隊列的事務狀態實現不能滿足事務管理器的職責,因為它(該事務狀態的職責)是只寫的。

由於預定義的放置策略現在可以公開訪問,因此在配置期間可以替換任何放置控制器。

共同努力

既然Orleans 3.0已經發布,我們也就會將注意力轉向未來的版本-我們有一些令人興奮的計劃!快來加入我們在GitHub和Gitter上的社區,幫助我們實現這些計劃。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※公開收購3c價格,不怕被賤賣!

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

Redis是什麼?看這一篇就夠了

本文由葡萄城技術團隊編撰並首發

轉載請註明出處:,葡萄城為開發者提供專業的開發工具、解決方案和服務,賦能開發者。

引言

在Web應用發展的初期,那時關係型數據庫受到了較為廣泛的關注和應用,原因是因為那時候Web站點基本上訪問和併發不高、交互也較少。而在後來,隨着訪問量的提升,使用關係型數據庫的Web站點多多少少都開始在性能上出現了一些瓶頸,而瓶頸的源頭一般是在磁盤的I/O上。而隨着互聯網技術的進一步發展,各種類型的應用層出不窮,這導致在當今雲計算、大數據盛行的時代,對性能有了更多的需求,主要體現在以下四個方面:

  1. 低延遲的讀寫速度:應用快速地反應能極大地提升用戶的滿意度
  2. 支撐海量的數據和流量:對於搜索這樣大型應用而言,需要利用PB級別的數據和能應對百萬級的流量
  3. 大規模集群的管理:系統管理員希望分佈式應用能更簡單的部署和管理
  4. 龐大運營成本的考量:IT部門希望在硬件成本、軟件成本和人力成本能夠有大幅度地降低

為了克服這一問題,NoSQL應運而生,它同時具備了高性能、可擴展性強、高可用等優點,受到廣泛開發人員和倉庫管理人員的青睞。

Redis是什麼

Redis是現在最受歡迎的NoSQL數據庫之一,Redis是一個使用ANSI C編寫的開源、包含多種數據結構、支持網絡、基於內存、可選持久性的鍵值對存儲數據庫,其具備如下特性:

  • 基於內存運行,性能高效
  • 支持分佈式,理論上可以無限擴展
  • key-value存儲系統
  • 開源的使用ANSI C語言編寫、遵守BSD協議、支持網絡、可基於內存亦可持久化的日誌型、Key-Value數據庫,並提供多種語言的API

相比於其他數據庫類型,Redis具備的特點是:

  • C/S通訊模型
  • 單進程單線程模型
  • 豐富的數據類型
  • 操作具有原子性
  • 持久化
  • 高併發讀寫
  • 支持lua腳本

哪些大廠在使用Redis?

  • github
  • twitter
  • 微博
  • Stack Overflow
  • 阿里巴巴
  • 百度
  • 美團
  • 搜狐

Redis的應用場景有哪些?

Redis 的應用場景包括:緩存系統(“熱點”數據:高頻讀、低頻寫)、計數器、消息隊列系統、排行榜、社交網絡和實時系統。


Redis的數據類型及主要特性

Redis提供的數據類型主要分為5種自有類型和一種自定義類型,這5種自有類型包括:String類型、哈希類型、列表類型、集合類型和順序集合類型。

String類型:

它是一個二進制安全的字符串,意味着它不僅能夠存儲字符串、還能存儲圖片、視頻等多種類型, 最大長度支持512M。

對每種數據類型,Redis都提供了豐富的操作命令,如:

  • GET/MGET
  • SET/SETEX/MSET/MSETNX
  • INCR/DECR
  • GETSET
  • DEL

哈希類型:

該類型是由field和關聯的value組成的map。其中,field和value都是字符串類型的。

Hash的操作命令如下:

  • HGET/HMGET/HGETALL
  • HSET/HMSET/HSETNX
  • HEXISTS/HLEN
  • HKEYS/HDEL
  • HVALS

列表類型:

該類型是一個插入順序排序的字符串元素集合, 基於雙鏈表實現。

List的操作命令如下:

  • LPUSH/LPUSHX/LPOP/RPUSH/RPUSHX/RPOP/LINSERT/LSET
  • LINDEX/LRANGE
  • LLEN/LTRIM

集合類型:

Set類型是一種無順序集合, 它和List類型最大的區別是:集合中的元素沒有順序, 且元素是唯一的。

Set類型的底層是通過哈希表實現的,其操作命令為:

  • SADD/SPOP/SMOVE/SCARD
  • SINTER/SDIFF/SDIFFSTORE/SUNION

Set類型主要應用於:在某些場景,如社交場景中,通過交集、並集和差集運算,通過Set類型可以非常方便地查找共同好友、共同關注和共同偏好等社交關係。

順序集合類型:

ZSet是一種有序集合類型,每個元素都會關聯一個double類型的分數權值,通過這個權值來為集合中的成員進行從小到大的排序。與Set類型一樣,其底層也是通過哈希表實現的。

ZSet命令:

  • ZADD/ZPOP/ZMOVE/ZCARD/ZCOUNT
  • ZINTER/ZDIFF/ZDIFFSTORE/ZUNION

Redis的數據結構

Redis的數據結構如下圖所示:

關於上表中的部分釋義:

  1. 壓縮列表是列表鍵和哈希鍵的底層實現之一。當一個列表鍵只包含少量列表項,並且每個列表項要麼就是小整數,要麼就是長度比較短的字符串,Redis就會使用壓縮列表來做列表鍵的底層實現
  2. 整數集合是集合鍵的底層實現之一,當一個集合只包含整數值元素,並且這個集合的元素數量不多時,Redis就會使用整數集合作為集合鍵的底層實現

如下是定義一個Struct數據結構的例子:


簡單動態字符串SDS (Simple Dynamic String)

基於C語言中傳統字符串的缺陷,Redis自己構建了一種名為簡單動態字符串的抽象類型,簡稱SDS,其結構如下:

SDS幾乎貫穿了Redis的所有數據結構,應用十分廣泛。

SDS的特點

和C字符串相比,SDS的特點如下:

  1. 常數複雜度獲取字符串長度

    Redis中利用SDS字符串的len屬性可以直接獲取到所保存的字符串的長
    度,直接將獲取字符串長度所需的複雜度從C字符串的O(N)降低到了O(1)。

  2. 減少修改字符串時導致的內存重新分配次數

    通過C字符串的特性,我們知道對於一個包含了N個字符的C字符串來說,其底層實現總是N+1個字符長的數組(額外一個空字符結尾)

    那麼如果這個時候需要對字符串進行修改,程序就需要提前對這個C字符串數組進行一次內存重分配(可能是擴展或者釋放) 

    而內存重分配就意味着是一個耗時的操作。

Redis巧妙的使用了SDS避免了C字符串的缺陷。在SDS中,buf數組的長度不一定就是字符串的字符數量加一,buf數組裡面可以包含未使用的字節,而這些未使用的字節由free屬性記錄。

與此同時,SDS採用了空間預分配的策略,避免C字符串每一次修改時都需要進行內存重分配的耗時操作,將內存重分配從原來的每修改N次就分配N次——>降低到了修改N次最多分配N次。

如下是Redis對SDS的簡單定義:


Redis特性1:事務

  • 命令序列化,按順序執行
  • 原子性
  • 三階段: 開始事務 – 命令入隊 – 執行事務
  • 命令:MULTI/EXEC/DISCARD

Redis特性2:發布訂閱(Pub/Sub)

  • Pub/sub是一種消息通訊模式
  • Pub發送消息, Sub接受消息
  • Redis客戶端可以訂閱任意數量的頻道
  • “fire and forgot”, 發送即遺忘
  • 命令:Publish/Subscribe/Psubscribe/UnSub


Redis特性3:Stream

  • Redis 5.0新增
  • 等待消費
  • 消費組(組內競爭)
  • 消費歷史數據
  • FIFO


以上就是Redis的基本概念,下面我們將介紹在開發過程中可能會踩到的“坑”。

Redis常見問題解析:擊穿

概念:在Redis獲取某一key時, 由於key不存在, 而必須向DB發起一次請求的行為, 稱為“Redis擊穿”。

引發擊穿的原因:

  • 第一次訪問
  • 惡意訪問不存在的key
  • Key過期

合理的規避方案:

  • 服務器啟動時, 提前寫入
  • 規範key的命名, 通過中間件攔截
  • 對某些高頻訪問的Key,設置合理的TTL或永不過期

Redis常見問題解析:雪崩

概念:Redis緩存層由於某種原因宕機后,所有的請求會湧向存儲層,短時間內的高併發請求可能會導致存儲層掛機,稱之為“Redis雪崩”。

合理的規避方案:

  • 使用Redis集群
  • 限流

Redis在產品開發中的應用實踐

為此,我很高興的為大家介紹,葡萄城架構師Jim將在2019-11-27 14:00 為大家帶來一場公開課,其中 Jim除了為大家講解Redis的基礎,同時也會實際演示他所在的項目組使用Redis時碰到的問題以及解決方案,對於剛接觸Redis的同學來說,更具參考意義和學習價值,歡迎大家屆時參加,公開課地址:。

  • 後端採用nodeJS
  • 使用Azure的Redis服務
  • Redis的使用場景

    -  token緩存, 用於令牌驗證

    -  IP白名單

碰到的問題

  • “網絡抖動”或者Redis服務異常導致Redis訪問超時
  • Redis客戶端驅動穩定性問題

    -  連接池 “Broken connection” 問題

    -  JS的Promise引出的Redis重置問題

下面我們來簡單了解一下Redis的進階知識。

進階之Redis協議簡介

Redis客戶端通訊協議:RESP(Redis Serialization Protocol),其特點是:

  • 簡單
  • 解析速度快
  • 可讀性好

Redis集群內部通訊協議:RECP(Redis Cluster Protocol ) ,其特點是:

  • 每一個node兩個tcp 連接
  • 一個負責client-server通訊(P: 6379)
  • 一個負責node之間通訊(P: 10000 + 6379)


Redis協議支持的數據類型:

  • 簡單字符(首字節: “+”)

        “+OK\r\n”

  • 錯誤(首字節: “-”)

        “-error msg\r\n”

  • 数字(首字節: “:”)

        “:123\r\n”

  • 批量字符(首字節: “$”)

        “&hello\r\nWhoa re you\r\n”

  • 數組(首字節: “*”)

        “*0\r\n”

        “*-1\r\n”

除了Redis,還有什麼NoSQL型數據庫

市面上類似於Redis,同樣是NoSQL型的數據庫有很多,如下圖所示,除了Redis,還有MemCache、Cassadra和Mongo。下面,我們就分別對這幾個數據庫做一下簡要的介紹:


Memcache:這是一個和Redis非常相似的數據庫,但是它的數據類型沒有Redis豐富。Memcache由LiveJournal的Brad Fitzpatrick開發,作為一套分佈式的高速緩存系統,被許多網站使用以提升網站的訪問速度,對於一些大型的、需要頻繁訪問數據庫的網站訪問速度的提升效果十分顯著。

Apache Cassandra:(社區內一般簡稱為C*)這是一套開源分佈式NoSQL數據庫系統。它最初由Facebook開發,用於儲存收件箱等簡單格式數據,集Google BigTable的數據模型與Amazon Dynamo的完全分佈式架構於一身。Facebook於2008將 Cassandra 開源,由於其良好的可擴展性和性能,被 Apple、Comcast、Instagram、Spotify、eBay、Rackspace、Netflix等知名網站所採用,成為了一種流行的分佈式結構化數據存儲方案。

MongoDB:是一個基於分佈式文件存儲、面向文檔的NoSQL數據庫,由C++編寫,旨在為WEB應用提供可擴展的高性能數據存儲解決方案。MongoDB是一個介於關係數據庫和非關係數據庫之間的產品,是非關係數據庫當中功能最豐富,最像關係型數據庫的,它支持的數據結構非常鬆散,是一種類似json的BSON格式。

總結

以上就是Redis入門介紹教程,如果各位還想了解更多,歡迎通過評論和私信的方式告訴我。


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※3c收購,鏡頭 收購有可能以全新價回收嗎?

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※賣IPHONE,iPhone回收,舊換新!教你怎麼賣才划算?

abp(net core)+easyui+efcore實現倉儲管理系統——ABP WebAPI與EasyUI結合增刪改查之二(二十八)


       在上一篇 文章中我們學習了TreeGrid的一些基礎知識,接下我們來創建我們開發組織管理功能用到的一些類。關於如何創建類我們之前的文章中已經寫了很多了,這裡會有些簡略。


四、定義應用服務接口需要用到的DTO類

      為了在進行查詢時使用, PagedOrgResultRequestDto被用來將模塊數據傳遞到基礎設施層.

       1. 在Visual Studio 2017的“解決方案資源管理器”中,右鍵單擊“ABP.TPLMS.Application”項目,在彈出菜單中選擇“添加” > “新建文件夾”,並重命名為“Orgs”

      2. 使用鼠標右鍵單擊我們剛才創建的“Orgs”文件夾,在彈出菜單中選擇“添加” > “新建文件夾”,並重命名為“Dto”。

      3.右鍵單擊“Dto”文件夾,然後選擇“添加” > “類”。 將類命名為 Paged OrgResultRequestDto,然後選擇“添加”。代碼如下。

using Abp.Application.Services.Dto;
using System;
using System.Collections.Generic;
using System.Text;
 

namespace ABP.TPLMS.Orgs.Dto
{

public class PagedOrgResultRequestDto : PagedResultRequestDto
    {
        public string Keyword { get; set; }
    }
}

      4.右鍵單擊“Dto”文件夾,然後選擇“添加” > “類”。 將類命名為 OrgDto,然後選擇“添加”。代碼如下。

using Abp.Application.Services.Dto;
using Abp.AutoMapper;
using ABP.TPLMS.Entitys;
using System;
using System.Collections.Generic;
using System.Text;
 

namespace ABP.TPLMS.Orgs.Dto
{

    [AutoMapFrom(typeof(Org))]
    public class OrgDto : EntityDto<int>
    {

        int m_parentId = 0;
        public string Name { get; set; }       

        public string HotKey { get; set; }
        public int ParentId { get { return m_parentId; } set { m_parentId = value; } }       

        public string ParentName { get; set; }
        public bool IsLeaf { get; set; }
        public bool IsAutoExpand { get; set; }       

        public string IconName { get; set; }
        public int Status { get; set; }
        public int Type { get; set; }      
        public string BizCode { get; set; }       

        public string CustomCode { get; set; }
        public DateTime CreationTime { get; set; }
        public DateTime UpdateTime { get; set; }

        public int CreateId { get; set; }
        public int SortNo { get; set; }
        public int _parentId {
            get { return m_parentId; }          

        }
    }
}


      5.右鍵單擊“Dto”文件夾,然後選擇“添加” > “類”。 將類命名為 CreateUpdateOrgDto,然後選擇“添加”。代碼如下。

using Abp.Application.Services.Dto;
using Abp.AutoMapper;
using ABP.TPLMS.Entitys;
using System;
using System.Collections.Generic;
using System.ComponentModel.DataAnnotations;
using System.Text;

 
namespace ABP.TPLMS.Orgs.Dto
{

    [AutoMapTo(typeof(Org))]
    public class CreateUpdateOrgDto : EntityDto<int>
    {

        public string Name { get; set; }
        [StringLength(255)]
        public string HotKey { get; set; }

        public int ParentId { get; set; }

        [Required]
        [StringLength(255)]
        public string ParentName { get; set; }

        public bool IsLeaf { get; set; }
        public bool IsAutoExpand { get; set; }

        [StringLength(255)]
        public string IconName { get; set; }

        public int Status { get; set; }
        public int Type { get; set; }

        [StringLength(255)]
        public string BizCode { get; set; }

        [StringLength(100)]
        public string CustomCode { get; set; }
        public DateTime CreationTime { get; set; }
        public DateTime UpdateTime { get; set; }

        public int CreateId { get; set; }
        public int SortNo { get; set; } 

    }
}


五、定義IOrgAppService接口

        6. 在Visual Studio 2017的“解決方案資源管理器”中,鼠標右鍵單擊“Org”文件夾,然後選擇“添加” > “新建項”,在彈出對話框中選擇“接口”。為應用服務定義一個名為 IOrgAppService 的接口。代碼如下。

using System;
using System.Collections.Generic;
using System.Text;
using Abp.Application.Services;
using ABP.TPLMS.Orgs.Dto; 


namespace ABP.TPLMS.Orgs
{
  public  interface IOrgAppService : IAsyncCrudAppService<//定義了CRUD方法

             OrgDto, //用來展示組織信息
             int, //Org實體的主鍵
             PagedOrgResultRequestDto, //獲取組織信息的時候用於分頁
             CreateUpdateOrgDto, //用於創建組織信息
             CreateUpdateOrgDto> //用於更新組織信息

    {
    }
}


      六、實現IOrgAppService

       7.在Visual Studio 2017的“解決方案資源管理器”中,右鍵單擊“Org”文件夾,然後選擇“添加” > “新建項”,在彈出對話框中選擇“類”。為應用服務定義一個名為 OrgAppService 的服務類。代碼如下。

using Abp.Application.Services;
using Abp.Domain.Repositories;
using ABP.TPLMS.Entitys;
using ABP.TPLMS.Orgs.Dto;
using System;
using System.Collections.Generic;
using System.Text;
 

namespace ABP.TPLMS.Orgs
{

    public class OrgAppService : AsyncCrudAppService<Org, OrgDto, int, PagedOrgResultRequestDto,
                            CreateUpdateOrgDto, CreateUpdateOrgDto>, IOrgAppService 

    {
        public OrgAppService(IRepository<Org, int> repository)

            : base(repository)

        { 

        }
    }
}

七 創建OrgController繼承自TPLMSControllerBase

      1. 在Visual Studio 2017的“解決方案資源管理器”中,右鍵單擊在領域層“ABP.TPLMS.Web.Mvc”項目中的Controller目錄。 選擇“添加” > “新建項…”。如下圖。


     2. 在彈出對話框“添加新項-ABP.TPLMS.Web.Mvc”中選擇“控制器類”,然後在名稱輸入框中輸入“OrgsController”,然後點擊“添加”按鈕。

     3.在OrgsController.cs文件中輸入如下代碼,通過構造函數注入對應用服務的依賴。

using System;
using System.Collections.Generic;
using System.Linq;
using System.Threading.Tasks;
using Abp.AspNetCore.Mvc.Authorization;
using Abp.Web.Models;
using ABP.TPLMS.Controllers;
using ABP.TPLMS.Orgs;
using ABP.TPLMS.Orgs.Dto;
using ABP.TPLMS.Web.Models.Orgs;
using Microsoft.AspNetCore.Mvc;


namespace ABP.TPLMS.Web.Controllers
{
    [AbpMvcAuthorize]
    public class OrgsController : TPLMSControllerBase
    {
        private readonly IOrgAppService _orgAppService;
        private const int MAX_COUNT= 1000;
        
        public OrgsController(IOrgAppService orgAppService)
        {
            _orgAppService = orgAppService;
        }
        [HttpGet]
        // GET: /<controller>/
        public IActionResult Index()
        {
            return View();
        }
        [DontWrapResult]
        [HttpPost]
        public string List()
        {         
            PagedOrgResultRequestDto paged = new PagedOrgResultRequestDto();
            paged.MaxResultCount = MAX_COUNT;
           var userList = _orgAppService.GetAll(paged).GetAwaiter().GetResult().Items;
            int total = userList.Count;
            var json = JsonEasyUI(userList, total);
            return json;
        }       
    }
}

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※公開收購3c價格,不怕被賤賣!

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

中油換電站今年採競標,Gogoro累計 285 站、光陽 146 站

中油從 107 年起,依據經濟部智慧電動機車能源補充設施普及計畫(公建計畫)於加油站建置電動機車充電、換電設備,去年僅睿能 Gogoro 參與設 144 站,今年增加光陽 Ionex,兩家採公開競標方式,由光陽 Ionex 獲得 3 標共 146 站,睿能 Gogoro 得到 1 標 48 站;其中,睿能 Gogoro 扣除合約到期站數,再加上先前自建設站,在台灣中油加油站中有 285 站可為消費者服務。

經濟部工業局委託台灣銀行辦理共同供應契約設備系統招標,其中電池交換設備系統得標廠商都需符合安全規範審核,108 年換電設備系統之得標廠商共有睿能 Gogoro 及光陽 Ionex 兩家,中油考量消費者的便利性及設備使用公平性兩大原則,於採購系統設備前即採取公開方式辦理合作經營招標。

中油表示,北部地區有 52 站與睿能 Gogoro 合作的換電站,今年合約陸續到期,睿能 Gogoro 依據契約與決標結果遷移設備,為執行公建計畫,中油將此52站列入今年建置194站換電站的地點,公建換電站依各縣市站點打散,再平均分4案開標,讓每一標案站點均涵蓋各縣市,投標結果為光陽 Ionex 獲得 3 標(146 站)、睿能 Gogoro 得 1 標(48 站),原先台灣中油與睿能 Gogoro 合約到期的52站中,有38站改由光陽Ionex得標。

中油指出,上述政府電動機車充、換電站公建計畫,於 107 年已執行 161 站,其中 144 座換電站均為睿能 Gogoro 所有,另有充電 17 站,今年預計建置 216 座充換電站,其中 194 座為換電站,光陽 Ionex 有 146 站、睿能 Gogoro 48 站,另有充電 22 站,以總數來說,再加上睿能 Gogoro 之前的自建站 79 站,其仍在台灣中油有 285 站,光陽 Ionex 有 146 站為消費者服務,明年亦將配合政府預算持續建置更多站點,協助政府綠能政策推動。

(本文內容由 授權使用。首圖來源:Gogoro)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※公開收購3c價格,不怕被賤賣!

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象