Java學習筆記 線程池使用及詳解

有點笨,參考了好幾篇大佬們寫的文章才整理出來的筆記….

字面意思上解釋,線程池就是裝有線程的池,我們可以把要執行的多線程交給線程池來處理,和連接池的概念一樣,通過維護一定數量的線程池來達到多個線程的復用。

好處

多線程產生的問題

一般我們使用到多線程的編程的時候,需要通過new Thread(xxRunnable).start()創建並開啟線程,我們可以使用多線程來達到最優效率(如多線程下載)。

但是,線程不是越多就越好,線程過多,創建和銷毀就會消耗系統的資源,也不方便管理。

除此之外,多線程還會造成併發問題,線程併發數量過多,搶佔系統資源從而導致阻塞。

線程池優點

我們將線程放入線程池,由線程池對線程進行管理,可以對線程池中緩衝的線程進行復用,這樣,就不會經常去創建和銷毀線程了,從而省下了系統的資源。

線程池能夠有效的控制線程併發的數量,能夠解決多線程造成的併發問題。

除此之外,線程池還能夠對線程進行一定的管理,如延時執行、定時循環執行的策略等

線程池實現

線程池的實現,主要是通過這個類ThreadPoolExecutor,其的構造參數非常長,我們先大概了解,之後再進行詳細的介紹。

public ThreadPoolExecutor(int corePoolSize,
    int maximumPoolSize,long keepAliveTime,
    TimeUnit unit,BlockingQueue workQueue,
    RejectedExecutionHandler handler)
  • corePoolSize:線程池核心線程數量
  • maximumPoolSize:線程池最大線程數量
  • keepAliverTime:當活躍線程數大於核心線程數時,空閑的多餘線程最大存活時間
  • unit:存活時間的單位
  • workQueue:存放線程的工作隊列
  • handler:超出線程範圍和隊列容量的任務的處理程序(拒絕策略)

這裏大概簡單說明一下線程池的運行流程:

當線程被添加到線程池中,如果線程池中的當前的線程數量等於線程池定義的最大核心線程數量(corePoolSize)了,此線程就會別放入線程的工作隊列(workQueue)中,等待線程池的調用。

Java提供了一個工具類Excutors,方便我們快速創建線程池,其底層也是調用了ThreadPoolExecutor

不過阿里巴巴Java規範中強制要求我們應該通過ThreadPoolExecutor來創建自己的線程池,使用Excutors容易造成OOM問題。

所以,我們先從Excutors開始學習,之後在對ThreadPoolExecutor進行詳細的講解

Excutors

由於Excutors是工具類,所以下面的介紹的都是其的靜態方法,如果是比較線程數目比較少的小項目,可以使用此工具類來創建線程池

PS:把線程提交給線程池中,有兩種方法,一種是submit,另外一種則是execute

兩者的區別:

  1. execute沒有返回值,如果不需要知道線程的結果就使用execute方法,性能會好很多。
  2. submit返回一個Future對象,如果想知道線程結果就使用submit提交,而且它能在主線程中通過Future的get方法捕獲線程中的異常

線程池可以接收兩種的參數,一個為Runnable對象,另外則是Callable對象

Callable是JDK1.5時加入的接口,作為Runnable的一種補充,允許有返回值,允許拋出異常。

主要的幾個靜態方法:

方法 說明
newFixedThreadPool(int nThreads) 創建固定大小的線程池
newSingleThreadExecutor() 創建只有一個線程的線程池
newCachedThreadPool() 創建一個不限線程數上限的線程池,任何提交的任務都將立即執行
newScheduledThreadPool(int nThreads) 創建一個支持定時、周期性或延時任務的限定線程數目的線程池
newSingleThreadScheduledExecutor() 創建一個支持定時、周期性或延時任務的單個線程的線程池

1.newSingleThreadExecutor

創建一個單線程化的線程池,它只會用唯一的工作線程來執行任務,保證所有任務按照指定順序(FIFO, LIFO, 優先級)執行,我們可以使用它來達到控制線程順序執行。

控制進程順序執行:

Thread thread1 = new Thread(new Runnable() {
            @Override
            public void run() {
                try {
                    System.out.println("這是線程1");
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
        });
Thread thread2 = new Thread(new Runnable() {
    @Override
    public void run() {
        try {
            System.out.println("這是線程2");
            Thread.sleep(1000);
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
    }
});
Thread thread3 = new Thread(new Runnable() {
    @Override
    public void run() {
        try {
            System.out.println("這是線程3");
            Thread.sleep(1000);
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
    }
});
//創建線程池對象
ExecutorService executorService = Executors.newSingleThreadExecutor();
//把線程添加到線程池中
executorService.submit(thread1);
executorService.submit(thread2);
executorService.submit(thread3);

之後出現的結果就是按照順序輸出

2.newFixedThreadPool

創建一個定長線程池,可控制線程最大併發數,超出的線程會在隊列中等待。定長線程池的大小最好根據系統資源進行設置。如Runtime.getRuntime().availableProcessors()

3.newCachedThreadPool

創建一個可緩存線程池,如果線程池長度超過處理需要,可靈活回收空閑線程,若無可回收,則新建線程,線程池為無限大,當執行第二個任務時第一個任務已經完成,會復用執行第一個任務的線程,而不用每次新建線程。

代碼:

//創建了一個自定義的線程
public class MyThread extends Thread {
    private int index;

    public MyThread(int index) {
        this.index = index;
    }

    @Override
    public void run() {
        System.out.println(index+" 當前線程"+Thread.currentThread().getName());
    }
}

//創建緩存線程池
ExecutorService executorService = Executors.newCachedThreadPool();
for (int i = 0; i < 10; i++) {
    executorService.execute(new MyThread(i));
    try {
        //這裏模擬等待時間,等待線程池復用回收線程
        Thread.sleep(1000);
    } catch (InterruptedException e) {
        e.printStackTrace();
    }
}

可以看到結果都是使用的同一個線程

4.newScheduledThreadPool

創建一個定長線程池,支持定時、周期性或延時任務執行

延遲1s后啟動線程:

ScheduledExecutorService scheduledExecutorService = Executors.newScheduledThreadPool(2);
scheduledExecutorService.schedule(new MyThread(1),1, TimeUnit.SECONDS);

ThreadPoolExecutor

構造方法

上面提到的那個構造方法其實只是ThreadPoolExecutor類中的一個,ThreadPoolExecutor類中存在有四種不同的構造方法,主要區別就是參數不同。

//五個參數的構造函數
public ThreadPoolExecutor(int corePoolSize,
                          int maximumPoolSize,
                          long keepAliveTime,
                          TimeUnit unit,
                          BlockingQueue<Runnable> workQueue)

//六個參數的構造函數-1
public ThreadPoolExecutor(int corePoolSize,
                          int maximumPoolSize,
                          long keepAliveTime,
                          TimeUnit unit,
                          BlockingQueue<Runnable> workQueue,
                          ThreadFactory threadFactory)

//六個參數的構造函數-2
public ThreadPoolExecutor(int corePoolSize,
                          int maximumPoolSize,
                          long keepAliveTime,
                          TimeUnit unit,
                          BlockingQueue<Runnable> workQueue,
                          RejectedExecutionHandler handler)

//七個參數的構造函數
public ThreadPoolExecutor(int corePoolSize,
                          int maximumPoolSize,
                          long keepAliveTime,
                          TimeUnit unit,
                          BlockingQueue<Runnable> workQueue,
                          ThreadFactory threadFactory,
                          RejectedExecutionHandler handler)

首先,有個概念需要明白,線程池的最大線程數(線程總數,maximumPoolSize)= 核心線程數(corePoolSize)+非核心線程數

  • corePoolSize:線程池核心線程數量
  • maximumPoolSize:線程池最大線程數量
  • keepAliverTime:當活躍線程數大於核心線程數時,空閑的多餘線程最大存活時間
  • unit:存活時間的單位
  • workQueue:存放線程的工作隊列
  • handler:超出線程範圍和隊列容量的任務的處理程序(拒絕策略)

核心線程和非核心線程有什麼區別呢?

核心線程是永遠不會被線程池丟棄回收(即使核心線程沒有工作),非核心線程則是超過一定時間(keepAliverTime)則就會被丟棄

workQueue

當所有的核心線程都在工作時,新添加的任務會被添加到這個隊列中等待處理,如果隊列滿了,則新建非核心線程執行任務

1.SynchronousQueue:這個隊列接收到任務的時候,會直接提交給線程處理,而不保留它,如果所有線程都在工作怎麼辦?那就新建一個線程來處理這個任務!所以為了保證不出現線程數達到了maximumPoolSize而不能新建線程的錯誤,使用這個類型隊列的時候,maximumPoolSize一般指定成Integer.MAX_VALUE,即無限大

2.LinkedBlockingQueue:這個隊列接收到任務的時候,如果當前線程數小於核心線程數,則新建線程(核心線程)處理任務;如果當前線程數等於核心線程數,則進入隊列等待。由於這個隊列沒有最大值限制,即所有超過核心線程數的任務都將被添加到隊列中,這也就導致了maximumPoolSize的設定失效,因為總線程數永遠不會超過corePoolSize

3.ArrayBlockingQueue:可以限定隊列的長度,接收到任務的時候,如果沒有達到corePoolSize的值,則新建線程(核心線程)執行任務,如果達到了,則入隊等候,如果隊列已滿,則新建線程(非核心線程)執行任務,又如果總線程數到了maximumPoolSize,並且隊列也滿了,則發生錯誤

4.DelayQueue:隊列內元素必須實現Delayed接口,這就意味着你傳進去的任務必須先實現Delayed接口。這個隊列接收到任務時,首先先入隊,只有達到了指定的延時時間,才會執行任務

拒絕策略:

拒絕策略 拒絕行為
AbortPolicy 拋出RejectedExecutionException異常(默認)
DiscardPolicy 不處理,丟棄掉
DiscardOldestPolicy 丟棄執行隊列中等待最久的一個任務,嘗試為新來的任務騰出位置
CallerRunsPolicy 直接由提交任務者執行這個任務

兩種方法設置拒絕策略:

//ThreadPoolExecutor對象的setRejectedExecutionHandler方法設置
ThreadPoolExecutor threadPool = new ThreadPoolExecutor(2, 5, 60, TimeUnit.SECONDS, queue);
threadPool.setRejectedExecutionHandler(new ThreadPoolExecutor.AbortPolicy());
//構造方法進行設置,省略

線程池默認的拒絕行為是AbortPolicy,也就是拋出RejectedExecutionHandler異常,該異常是非受檢異常,很容易忘記捕獲。

如果不關心任務被拒絕的事件,可以將拒絕策略設置成DiscardPolicy,這樣多餘的任務會悄悄的被忽略。

ThreadFactory

一個接口類,用來對線程進行設置,需要實現newThread(Runnable r)方法

官方的文檔說明:

newThread此方法一般來初始化線程的優先級(priority),名字(name),守護進程(daemon)或線程組(ThreadGroup)

簡單的例子(讓某個類實現ThreadFactory接口):

@Override
public Thread newThread(Runnable r) {
    Thread thread = new Thread(r);
    thread.setDaemon(true);
    return thread;
}

線程池獲取執行結果

PS:把線程提交給線程池中,有兩種方法,一種是submit,另外一種則是execute

兩者的區別:

  1. execute沒有返回值,如果不需要知道線程的結果就使用execute方法,性能會好很多。
  2. submit返回一個Future對象,如果想知道線程結果就使用submit提交,而且它能在主線程中通過Future的get方法捕獲線程中的異常

線程池可以接收兩種的參數,一個為Runnable對象,另外則是Callable對象

Callable是JDK1.5時加入的接口,作為Runnable的一種補充,允許有返回值,允許拋出異常。

線程池的處理結果、以及處理過程中的異常都被包裝到Future中,並在調用Future.get()方法時獲取,執行過程中的異常會被包裝成ExecutionException,submit()方法本身不會傳遞結果和任務執行過程中的異常。

獲取執行結果的代碼可以這樣寫:

ExecutorService executorService = Executors.newFixedThreadPool(4);
Future<Object> future = executorService.submit(new Callable<Object>() {
        @Override
        public Object call() throws Exception {
            //該異常會在調用Future.get()時傳遞給調用者
            throw new RuntimeException("exception in call~");
        }
    });
    
try {
    //獲得返回結果
    Object result = future.get();
    
    
} catch (InterruptedException e) {
  // interrupt
} catch (ExecutionException e) {
  // exception in Callable.call()
  e.printStackTrace();
}

線程池運行流程

一個形象的比喻說明線程池的流程:

規定:

  1. 線程池比作成一家公司
  2. 公司的最大員工數為maximumPoolSize
  3. 最大正式員工數為coolPoolSize(核心線程的總數)
  4. 最大員工數(maximumPoolSize) = 最大正式員工(coolPoolSize)和臨時工(非核心線程)
  5. 單子(任務)可看做為線程
  6. 隊列使用的是ArrayBlockingQueue
  7. 一個員工只能幹一個任務

最開始的時候,公司是沒有一名員工。之後,公司接到了單子(任務),這個時候,公司才去找員工(創建核心線程並讓線程開始執行),這個時候找到的員工就是正式員工了。

公司的聲譽越來越好,於是來了更多的單子,公司繼續招人,直到正式員工數量達到最大的正式員工的數量(核心線程數量已達到最大)

於是,多出來的單子就暫時地存放在了隊列中,都在排隊,等待正式員工們把手頭的工作做完之後,就從隊列中依次取出單子繼續工作。

某天,來了一個新單子,但是這個時候隊列已經滿了,公司為了自己的信譽和聲譽着想,不得已只能去找臨時工(創建非核心線程)來幫忙開始進行工作(負責新單子)

在此之後,又來了新單子,公司繼續去招臨時工為新來的單子工作,直到正式工和臨時工的數量已經達到了公司最大員工數。

這個時候,公司沒有辦法了,只能拒絕新來的單子了(拒絕策略)

此時,正式工和臨時工都是在加班加點去從隊列中取出任務來工作,終於某一天,隊列的已經沒有單子了,市場發展不好,單子越來越少,臨時工很久都不工作了(非核心線程超過了最大存活時間keepAliveTime),公司就把這些臨時工解僱了,直到剩下只有正式員工。

PS:如果也想要解僱正式員工(銷毀核心線程),可以設置ThreadPoolExecutor對象的的allowCoreThreadTimeOut這個屬性為true

個人理解,可能不是很正確,僅供參考!

線程池關閉

方法 說明
shutdown() 不再接受新的任務,之前提交的任務等執行結束再關閉線程池
shutdownNow() 不再接受新的任務,試圖停止池中的任務再關閉線程池,返回所有未處理的線程list列表。

總結

如果是小的Java程序,可以使用Excutors,如果是服務器程序,則使用ThreadPoolExecutor進行自定義線程池的創建

參考鏈接:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選
GDG Xi’an DevFest 2019 閃電演講 -《假如我是一個瀏覽器》PPT(經典多圖,建議收藏)

GDG Xi’an DevFest2019演講PPT鏈接:

閃電演講《假如我是一個瀏覽器》PPT鏈接:

關於我的一篇雞湯文,獻給所有努力中的野生前端:

摘要

內容講述了HTML,CSS和JavaScript文件從代碼到瀏覽器中圖形的基本過程,實際上每個階段正好代表了高級前端工程師可以選擇的三大細分方向——架構師,工程化,圖形學。PPT基本上全是圖,引用了一些知名的前端神圖,大部分都是自己一點點做的,畢竟圖的表現力比文字要生動直觀一些,原稿幾乎每一頁都加了備註!!!,有需要的可以在我的博客或者GDG西安官方公眾號獲取到。

作者簡介

請求階段

請求階段從解析DNS開始,它是一個遞歸的過程,可以在Linux系統中使用dig+trace工具進行追蹤查看;查詢到地址后就需要開始建立連接(三次握手建立連接),然後從服務器獲取第一個文件,通常是index.html,獲取到文件后就需要根據響應頭裡的信息進行一些處理,對這塊不太熟悉的同學可以閱讀《圖解Http》一書,強制緩存和協商緩存這一塊是很重要的考點,index.html在解析時可能還會碰到請求其他資源的情況,這時又會引出CDN等等其他話題,本次分享中並未涉及。如果對於前端可用性及資源部署方面感興趣,可以考慮向架構師的方向發展,也就是只將前端應用視為整個鏈路中的一環,嘗試去關注整個鏈路中各個環節,前端工程師切入時並不需要特別關注去解決細枝末節的技術問題,那畢竟需要時間和經驗的積累,請記住你是有夥伴的,我個人比較推薦前端工程師嘗試建設全鏈路的異常監控體系,去了解各個環節有哪些關鍵指標,如何去呈現,如何去判斷異常等等,以盡可能穩定有效的方式把關鍵信息呈現給能解決問題的人。

解析階段

我在分享時已經提及過,解析階段的關鍵詞就是“編譯原理”,前端基礎的HTML,CSS,JS,以及常見的工程化工具例如Webpack,Babel,Eslint等等,全部都是基於編譯原理來運作的,如果從純學術的角度來看,它的確很晦澀,但是從應用的角度來理解,實際上無論是分詞,轉換還是遍歷AST以及最終的代碼生成,實際上都是看得見摸得着的,並不算特別難理解,B站上有很多國內外的《編譯原理》課程錄像,你懂的(B站真的是學習用的)。其中還涉及到了一些基本的數據結構和基礎算法的知識,這裏的知識是對基本功的硬考驗,也就是“設計模式”“數據結構”和“基礎算法”的三座大山,爬山很慢,但真的很值。這一塊的知識可以翻看朱永盛的《Webkit技術內幕》一書,慎重,沒有老司機帶的話這本書很容易看的人懷疑人生。

種樹階段

種樹階段只是戲稱,就是為了不同的目的構建了許許多多的樹和層。HTML解析後生成DOM樹,它表示文檔的結構,CSS在內部優化時也會生成樹,為了將用於渲染的信息整合在一起,兩者被合併生成了RenderObject樹,為了解決層疊順序問題,又在此基礎上生成了RenderLayer層,為了利用硬件加速渲染,又為滿足另一些條件的層生成CompositingLayer合成層,合成層又使用GraphicsLayer來進行後端存儲。概念之多,相對複雜。為了排除干擾,本次分享中並沒有講述Chrome瀏覽器的多進程模型和多線程結構,它們只是為了更好更高效地處理好關鍵渲染步驟,一次性信息量太大反而會影響吸收。

畫畫階段

畫畫階段實際上是指將對象信息通過光柵化處理后得到位圖信息並展示在显示器上的過程,PPT中並沒有涉及,它涉及到很多圖形學相關的知識,基本的WebGL以及Chromium渲染管線方面的知識。對此感興趣的讀者可以掃描下面的二維碼關注我技術博客中系列博文,比較詳細地描述了這部分相關知識。最後提一下,原稿最後一頁的資料在播放模式下都可以直接點擊跳轉,還有每一頁的備註信息如果看不見可能需要手動把畫面向上拖拽縮小一點。

硬廣時間

我的博文集《大史住在大前端》是關於前端基礎的文章,掃下面右邊的二維碼就可以看到,基本都是系列專題,沒有太多關於三大框架或是熱門技術的東西,都是基礎基礎基礎,或許會對你有幫助。最後再次感謝GDGXi’an提供的這次機會,讓我認識了好多好多優秀的大佬和開發者。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※3c收購,鏡頭 收購有可能以全新價回收嗎?

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※賣IPHONE,iPhone回收,舊換新!教你怎麼賣才划算?

【python測試開發棧】python內存管理機制(一)—引用計數

什麼是內存

在開始進入正題之前,我們先來回憶下,計算機基礎原理的知識,為什麼需要內存。我們都知道計算機的CPU相當於人類的大腦,其運算速度非常的快,而我們平時寫的數據,比如:文檔、代碼等都是存儲在磁盤上的。磁盤的存取速度完全不能匹配cpu的運算速度,因此就需要一个中間層來適配兩者的不對等,內存由此而來,內存的存取速率很快,但是存儲空間不大。

舉一個圖書館的例子,便於大家理解,我們圖書館的書架就相當於磁盤,存放了大量的圖書可以供我們閱讀,但是如果書放在書架上,我們沒辦法直接閱讀(效率低),只能將書取出來,放在書桌上看,那書桌就相當於內存。

內存回收

內存資源畢竟是有限的,所以在使用之後,必須被回收掉,否則系統運行一段時間后就會因無內存可用而癱瘓。我們軟件測試領域常用的兩種語言:java和python,全部都採用內存自動回收的方法,也就是我們只管申請內存,但是不管釋放內存,由jvm和python解釋器來定期觸發內存回收。作為對比,C語言和C++中,程序員需要使用malloc申請內存,使用free去釋放內存,malloc和free必須成對的出現,否則非常容易出現內存問題。

還拿上面圖書館的例子,假如圖書館的書看完之後放在書桌上就可以(因為圖書可自動回收),那麼很快的,就沒有位置給新進來的同學看書了。這時候就需要圖書館管理員(jvm或python解釋器)定期的回收圖書,清空書桌。不過正常情況下,我們離開圖書館時,要自己清空書桌,將書放回書架(類似C語言和C++的內存回收方式)。

python內存管理

引用計數

python通過引用計數來進行內存管理,每一個python對象,都維護了一個指向該對象的引用計數。python的sys庫提供了getrefcount()函數來獲取對象的引用計數。下面我們看個例子(注意:不同版本的python,運行結果不同,我這裏採用的是python3.7.4):

"""
    @author: xuanke
    @time: 2019/11/27
    @function: 測試python內存
"""
import sys

class RefClass(object):
    def __init__(self):
        print("this is init")

def ref_count_test():
    # 驗證普通字符串
    str1 = "abc"
    print(sys.getrefcount(str1))
    # 驗證稍微複雜點的字符串
    print(sys.getrefcount("xuankeTester"))
    # 驗證小的数字
    print(sys.getrefcount(12))
    # 驗證大的数字
    print(sys.getrefcount(257))
    # 驗證類
    a = RefClass()
    print(sys.getrefcount(a))
    # 驗證引用計數增加
    b = a
    print(sys.getrefcount(a))

    # 驗證引用計數減少
    b = None
    print(sys.getrefcount(a))

if __name__ == '__main__':
    ref_count_test()

大家先來思考下,最終的結果會是什麼?!我覺得應該很多人都會答錯,因為不同版本的python,對引用變量個數有影響(主要是可復用的對象)。我們先貼出來運行結果,再來分析產生結果的原因:

27
4
9
3
this is init
2
3
2

不過提前聲明一點:sys.getrefcount函數在使用時,因為將對象(比如上例中的str1)作為參數傳入,所以會額外增加一個變量(相當於getrefcount持有了str1的引用),因此實際每個對象的實際引用計數都得減1。下面分別介紹下上面的幾種情況:

  • 字符串: str1=’abc’的引用數是27-1=26,是因為字符串’abc’比較簡單,在python解釋器(CPython)中確實可能存在26個引用。作為對比,在python2.7中,str1的引用變量個數是3-1=2。而字符串’xuanketester’,是我自定義的一個字符串,所以不可能會有其他額外的引用,所以其引用變量個數是3-1=2(至於為什麼是2,理論應該是0,是因為python解釋器默認持有了所有字符串的兩個引用)。
  • 数字: 数字12對應的引用計數個數是9-1=8,而257對應的引用計數個數是3-1=2,這主要是因為,在python初始化過程中,就創建了從-5到256的数字,緩存起來,這樣做是為了頻繁的分配內存,提高效率。而對於不在這個區間的数字,則會重新分配內存空間。所以数字12因為被複用,其引用計數個數是8(在python2.7.14中,其引用計數個數是8)。
  • 類: 在上面例子中,創建一個RefClass對象,其引用計數就是2-1=1,因為其是一個我們自定義的類對象,在python解釋器(Cpython)中肯定不會被複用。

我們可以通過打印內存地址的方式來驗證上面這幾種情況:

    def memory_address_test():
    str1 = 'xuankeTester'
    str2 = 'xuankeTester'
    print(id(str1))
    print(id(str2))

    str3 = 'abc'
    str4 = 'abc'
    print(id(str3))
    print(id(str4))

    a = 12
    b = 12
    print(id(a))
    print(id(b))

    c = 257
    d = 257
    print(id(c))
    print(id(d))

按照我們上面的分析,c和d的地址應該是不一樣的,a和b的地址是一樣的,字符串str1和str2、str3和str4內存地址都是一樣的。但是我在pycharm中,直接運行py文件,結果卻和預想的不一致,結果如下:

2854496960176
2854496960176
2854496857840
2854496857840
140724423258720
140724423258720
2854498931120
2854498931120

所有情況的內存地址都是一樣的,這是為什麼呢?我考慮到是不是pycharm對py文件做了優化,於是我又在命令行嘗試執行,結果還是一樣的。所以,我猜測可能是python解釋器在執行文件時,為了提高py文件的執行效率,對文件的內存地址做了優化—相同內容的對象內存地址都一樣。

為了驗證這個想法,我直接在python交互模式下執行,果然得到了我想要的結果:

Python 3.7.4 (tags/v3.7.4:e09359112e, Jul  8 2019, 20:34:20) [MSC v.1916 64 bit (AMD64)] on win32
Type "help", "copyright", "credits" or "license" for more information.
>>> a=12
>>> b=12
>>> id(a)
140724423258720
>>> id(b)
140724423258720
>>> a=257
>>> b=257
>>> id(a)
2559155778384
>>> id(b)
2559155778192
>>> a='xuankeTester'
>>> b='xuankeTester'
>>> id(a)
2559155711280
>>> id(b)
2559155711280
>>>

從上面可以看到兩個257對應的地址確實是不一樣的,和我們最初判斷的是一致的。

總結

python通過對象的引用計數來管理內存,其實java的JVM也有用引用計數,所以理解了引用計數,為我們理解python的垃圾回收方法打下了基礎。本計劃這一篇文章就將python內存管理的機制講完的,但是發現一個內存引用計數就有很多東西得寫,所以索性就分兩篇文章來寫,之後再寫一篇文章來介紹python的垃圾回收方式。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※3c收購,鏡頭 收購有可能以全新價回收嗎?

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※賣IPHONE,iPhone回收,舊換新!教你怎麼賣才划算?

.NET Core 3.0 使用Nswag生成Api文檔和客戶端代碼

摘要

在前後端分離、Restful API盛行的年代,完美的接口文檔,成了交流的紐帶。在項目中引入Swagger (也稱為OpenAPI),是種不錯的選擇,它可以讓接口數據可視化。下文將會演示

  • 利用Nswag如何生成Api文檔

  • 利用NSwagStudio如何生成客戶端代碼,並且進行測試

什麼是 Swagger/OpenAPI?

Swagger 是一個與語言無關的規範,用於描述 REST API。Swagger 項目已捐贈給 OpenAPI 計劃,現在它被稱為開放 API。這兩個名稱可互換使用,但 OpenAPI 是首選。它允許計算機和人員了解服務的功能,而無需直接訪問實現(源代碼、網絡訪問、文檔)。其中一個目標是盡量減少連接取消關聯的服務所需的工作量。另一個目標是減少準確記錄服務所需的時間。

Nswag VS Swashbuckle?

.NET Swagger 實現類庫有兩個比較流行:

  • Swashbuckle.AspNetCore 是一個開源項目,用於生成 ASP.NET Core Web API 的 Swagger 文檔。

  • NSwag 是另一個用於生成 Swagger 文檔並將 Swagger UI 或 ReDoc 集成到 ASP.NET Core Web API 中的開源項目。此外,NSwag 還提供了為 API 生成 C# 和 TypeScript 客戶端代碼的方法。


為什麼我在.NET core3.0中選擇NSwag呢,NSwag比較活躍,一直在更新,功能也很強大,可以完美的代替Swashbuckle.AspNetCore具體可以參考:https://github.com/aspnet/AspNetCore.Docs/issues/4258

一、利用Nswag生成Api文檔

步驟
  1. 創建Asp.NET Core Api項目,並且集成NSwag

  2. 配置項目

  3. 運行項目

創建Asp.NET Core Api項目,並且集成NSwag

我們將簡單的創建一個ASP.NET core API項目。將其命名為“WebAPIwithSwg”。基於.NETcore3.0

安裝nuget包NSwag.AspNetCore

接下來,在Startup.cs文件中配置Nswag服務和中間件。

在ConfigureServices方法中添加服務

  public void ConfigureServices(IServiceCollection services)
        {
            services.AddControllers();
            services.AddSwaggerDocument(); //註冊Swagger 服務
        }
在Configure方法中添加Nswag中間件
 public void Configure(IApplicationBuilder app, IWebHostEnvironment env)
        {
            if (env.IsDevelopment())
            {
                app.UseDeveloperExceptionPage();
            }
            app.UseRouting();
            app.UseAuthorization();
            app.UseEndpoints(endpoints =>
            {
                endpoints.MapControllers();
            });
            app.UseOpenApi(); //添加swagger生成api文檔(默認路由文檔 /swagger/v1/swagger.json)
            app.UseSwaggerUi3();//添加Swagger UI到請求管道中(默認路由: /swagger).
        }
配置項目

運行項目

右鍵項目在瀏覽器中查看,查看swagger UI需要在url後面添加“/swagger”。本示例http://localhost:54117/swagger

二、利用NSwagStudio如何生成客戶端代碼,並且進行測試
提供GUI界面是NSwag的一大特點,只需要下載安裝NSwagStudio,即可生成客戶端代碼。
步驟
  1. 現在安裝NSwagStudio

  2. NSwagStudio配置,生成客戶端代碼

  3. 創建測試客戶端項目

下載安裝NSwagStudio

下載NSwag Studio http://rsuter.com/Projects/NSwagStudio/installer.php 安裝之後打開 NSwag Studio 如圖

NSwagStudio配置,生成客戶端代碼

選擇runtime,我選擇的是NETCore30,切換OpenAPI/Swagger Specification ,在Specification URL 輸入你的Swagger.json路徑,本示例:http://localhost:54117/swagger/v1/swagger.json輸入路徑之後,點擊 create local copy 按鈕獲取json。

接下配置來生成客戶端代碼。我們首先選擇“csharp client”複選框,然後勾選掉 “Inject Http Client via Constructor (life cycle is managed by caller)” ,最後設置下輸出路徑 點擊生成文件(Generate Files)。步驟如下

到此客戶端代碼已經自動生成。

查看生成的部分代碼


public async System.Threading.Tasks.Task<System.Collections.Generic.ICollection<WeatherForecast>> GetAsync(System.Threading.CancellationToken cancellationToken)
        {
            var urlBuilder_ = new System.Text.StringBuilder();
            urlBuilder_.Append(BaseUrl != null ? BaseUrl.TrimEnd('/') : "").Append("/WeatherForecast");
    
            var client_ = new System.Net.Http.HttpClient();
            try
            {
                using (var request_ = new System.Net.Http.HttpRequestMessage())
                {
                    request_.Method = new System.Net.Http.HttpMethod("GET");
                    request_.Headers.Accept.Add(System.Net.Http.Headers.MediaTypeWithQualityHeaderValue.Parse("application/json"));
    
                    PrepareRequest(client_, request_, urlBuilder_);
                    var url_ = urlBuilder_.ToString();
                    request_.RequestUri = new System.Uri(url_, System.UriKind.RelativeOrAbsolute);
                    PrepareRequest(client_, request_, url_);
    
                    var response_ = await client_.SendAsync(request_, System.Net.Http.HttpCompletionOption.ResponseHeadersRead, cancellationToken).ConfigureAwait(false);
                    try
                    {
                        var headers_ = System.Linq.Enumerable.ToDictionary(response_.Headers, h_ => h_.Key, h_ => h_.Value);
                        if (response_.Content != null && response_.Content.Headers != null)
                        {
                            foreach (var item_ in response_.Content.Headers)
                                headers_[item_.Key] = item_.Value;
                        }
    
                        ProcessResponse(client_, response_);
    
                        var status_ = ((int)response_.StatusCode).ToString();
                        if (status_ == "200") 
                        {
                            var objectResponse_ = await ReadObjectResponseAsync<System.Collections.Generic.ICollection<WeatherForecast>>(response_, headers_).ConfigureAwait(false);
                            return objectResponse_.Object;
                        }
                        else
                        if (status_ != "200" && status_ != "204")
                        {
                            var responseData_ = response_.Content == null ? null : await response_.Content.ReadAsStringAsync().ConfigureAwait(false); 
                            throw new ApiException("The HTTP status code of the response was not expected (" + (int)response_.StatusCode + ").", (int)response_.StatusCode, responseData_, headers_, null);
                        }
            
                        return default(System.Collections.Generic.ICollection<WeatherForecast>);
                    }
                    finally
                    {
                        if (response_ != null)
                            response_.Dispose();
                    }
                }
            }
            finally
            {
                if (client_ != null)
                    client_.Dispose();
            }
        }
創建測試客戶端項目

創建一個控製程序項目,命名“WebApiClient”。

把自動生成的類“WeatherForecastClient”添加到客戶端項目中,然後安裝Newtonsoft

最後在Main函數中添加測試代碼,開始使用Api。

 static async System.Threading.Tasks.Task Main(string[] args)
        {

            var weatherForecastClient = new WeatherForecastClient();
            //gets all values from the API
            var allValues = await weatherForecastClient.GetAsync();
            Console.WriteLine("Hello World!");
        }

運行客戶端應用程序,進行調用api

當然如果需要調試api項目內部代碼,可以設置斷點,進入一步一步的調試

小結:NSwag 功能遠不止這些,本篇文章演示了如何生成api文檔和自動生成的api客戶端代碼方便我們調試,也可以作為對應的sdk。

參考:微軟官方文檔—https://docs.microsoft.com/zh-cn/aspnet/core/tutorials/getting-started-with-nswag?view=aspnetcore-2.2&tabs=visual-studio

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

JavaScript 是否應該重命名

  在誕生 25 年之後,JavaScript 語言仍然讓很多人困惑不已。所以一個老生常談的問題是:它是否應該重命名?呼籲改名的支持者列舉了一系列理由,包括:

  • JavaScript 本意指的是 ECMAScript 的子集,但使用中它經常被指代多種不同的 ECMAScript 超集
  • JavaScript 是甲骨文公司的商標,這與 JavaScript 作為 Web 平台核心組件的身份不相符合,Web 平台是建立在開放技術和標準基礎上的
  • JavaScript 連官方 logo 都沒有
  • JavaScript 與 Java 沒有一點關係,幾十年來它給非技術人員造成了混淆。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※3c收購,鏡頭 收購有可能以全新價回收嗎?

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※賣IPHONE,iPhone回收,舊換新!教你怎麼賣才划算?

雅虎日本在其餐廳徵收“油炸食品稅”

  為了推廣健康生活方式,減少僱員中間的肥胖率,雅虎日本在其總部餐廳開始徵收“油炸食品稅”。從 10 月 8 日開始,炸豬排之類的油炸食品價格上漲,而水煮魚或烤魚之類的魚類食品則價格下降。

  它在 2017 年的體檢显示,45% 的僱員 LDL 膽固醇含量較高。它的自助餐廳每天有 1000 名僱員吃飯,油炸食品要比水煮魚或烤魚受歡迎得多。除了炸豬排漲價外,炸雞排也漲了 100 日元至 691 日元。如今到了午餐點,魚類食品一售而空,官員表示效果顯著。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

傳谷歌母公司欲收購Fitbit 擬推自有品牌可穿戴設備

  原標題:Google is reportedly trying to buy Fitbit

  網易科技訊,10 月 29 日消息,據外媒報道,據知情人士透露,谷歌母公司 Alphabet 正在就收購美國可穿戴設備公司 Fitbit 與後者進行談判。不過,目前兩家公司還沒有確認這筆交易,也不清楚 Alphabet 的報價。上個月,有報道稱 Fitbit 正在探索出售的可能。

  多年來,谷歌憑藉其 Wear OS 操作系統在可穿戴市場上佔據了重要地位,但它始終難以與 Apple Watch 競爭,儘管其得到了包括 LG、Fossil 和 TicWatch 在內的眾多公司支持。就連主要的安卓製造商三星也未使用 Wear OS,而是使用自己的 Tizen 操作系統。

  今年 1 月,谷歌斥資 4000 萬美元從 Fossil 手中收購了某種智能手錶技術,但目前尚不清楚該技術到底是什麼,Fossil 高管將其描述為“尚未投放市場的新產品創新”,不過迄今仍然沒有上市。

  多年來,始終有傳言稱谷歌希望推出自家品牌的 Pixel 智能手錶。在 2016 年的某個時候,這些計劃幾乎促使谷歌品牌的智能手錶上市,但該公司最終擱置了計劃,因為其擔心這些手錶可能“傷及谷歌硬件品牌的聲譽”。這些 LG 製造的智能手錶後來在 2017 年以 LG Watch Sports 和 LG Watch Style 的形式發布,評價一般。

  從那時起,谷歌打造自家硬件野心開始膨脹。2017 年,谷歌收購了 HTC 智能手機工程團隊以開發 Pixel 手機,而 Fitbit 的收購可能會幫助其在可穿戴設備領域取得類似的進展。

  與此同時,蘋果在 Apple Watch 上的經驗表明,健康正迅速成為智能手錶的殺手級應用,這也是 Fitbit 自身健身追蹤器越來越關注的一個領域。然而,儘管 Fitbit 在 2016 年收購了智能手錶製造商 Pebble,但其在智能手錶方面的表現卻不盡如人意。例如,今年早些時候發布的健身跟蹤器 Fitbit Versa 2,其實本質上就是一款普通的智能手錶。

  谷歌和 Fitbit 拒絕就上述報道置評。(小小)


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

使用 Cloudflare 防火牆 Zone Lockdown 保護網站控制台及登入頁面教學


Copyright : Weerapat Kiatdumrong / 123RF Stock Photos

我在 WordCamp Taipei 2018 分享這幾年經營免費資源網路社群的經驗,當中也提到我選用的工具服務和理由,作為一個樂於分享的使用者,其實沒有什麼不可告人的「秘方」,反倒很希望能夠將自身經驗拋出來讓大家參考,獲得更多回饋,通常在交流過程中可以使自己學習很多。雖然沒有任何作法可以 100% 符合所有網站需求,但我還是希望透過文章傳遞一些你可能會用到、足以解決問題的觀點,當然這些不應太過複雜,至少要能讓大家願意閱讀,我寫的文章才會有所用處。

在演講時我不斷提到一個推薦的服務 Cloudflare,兼具我重視的速度和安全性,除了是一款內容傳遞網路(CDN)服務外,更重要的是它提供許多安全工具,可以增加網站的防護力,不要覺得你的網站很安全或不會被盯上,事實上有很多的自動化程式都是隨機尋找可下手攻擊或植入惡意程式的目標,因此平常就要做好安全措施,總不可能等到被入侵才來修補漏洞。

如果你使用 WordPress 架站,最需要防護的控制台(wp-admin)和登入頁面(wp-login.php)絕對別輕忽,早先很多網站都是教你透過 .htaccess 限制可連線的 IP 位址,若你已經開始使用 Cloudflare 的話,可以把這部分丟給 Cloudflare 協助處理,我相信它在安全防護上會更強大也更具有彈性和空間。

本文要介紹 Cloudflare 其中一個模組「Zone Lockdown」,這個模組在防火牆(Firewall)頁面底下,可以想見它和防護有關,簡單來說,利用 Zone Lockdown 功能可設定要加強防護的區域,讓使用者預先設定某些路徑僅能讓某個 IP(或 IP 範圍)來源存取,如果運用在 WordPress 最基本的用法是把登入頁面和控制台設定進去,如此一來就能確保只有你可以存取控制台,不僅大幅降低被攻擊入侵的機會,也能不被暴力測試帳號密碼消耗主機資源。

我之前也推薦過另一個方法:啟用 Jetpack「單一登入」機制教學,讓你的 WordPress 網站更安全(含兩步驟驗證),也能讓 WordPress 更加安全,你可以挑一個適合自己需求的使用,那麼接下來我會更深入說明 Zone Lockdown 功能。

使用教學

STEP 1

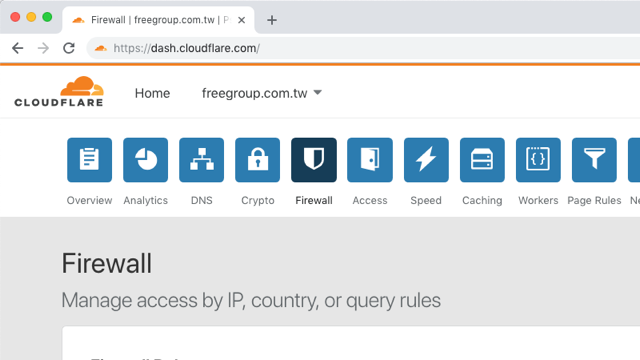
首先,你可以在登入 Cloudflare、選擇你的區域(網域名稱)後點選 Firewall 找到這項功能。

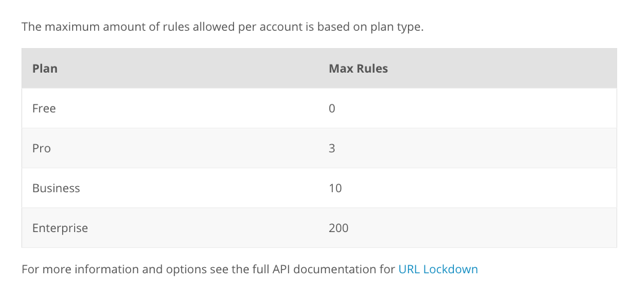
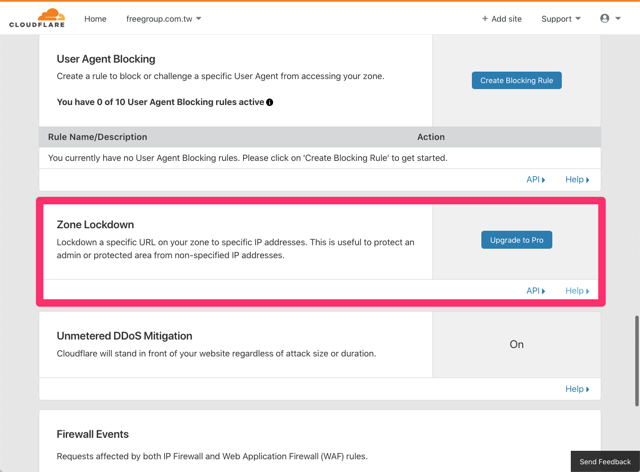
Zone Lockdown 暫不提供 Cloudflare 免費帳戶使用,如果你是免費方案,會要求升級到 Pro 或更高的方案才能開啟這項工具。Pro 帳戶可提供三個規則設定,Business 則有 10 個額度,其實數量不用太多,若你已經升級到最基本的 Pro 方案就可以滿足基本需求,除非你想設定很複雜的規則。

STEP 2

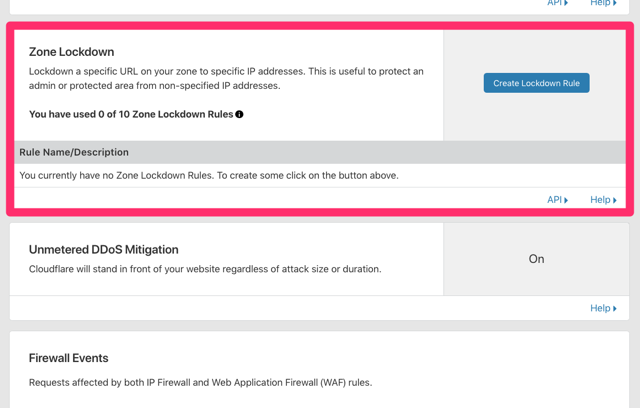
如果你是付費方案,應該會看到 Zone Lockdown 功能已被開啟,點選「Create Lockdown Rule」建立第一個網址防護規則。

STEP 3

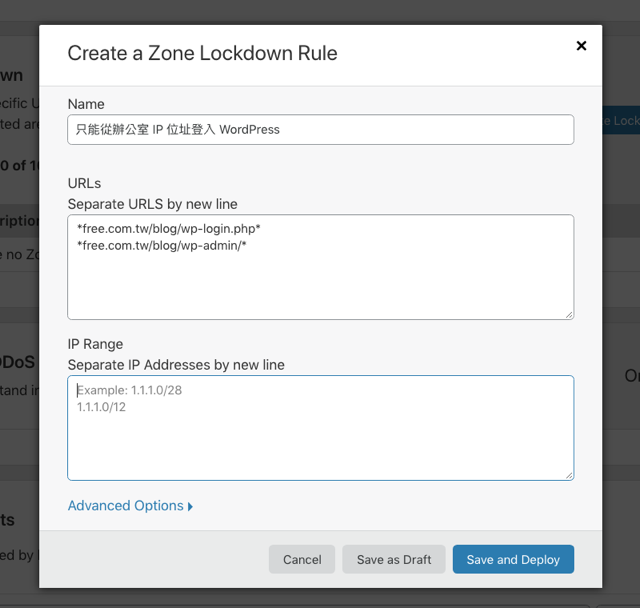
在這裡我以一般 WordPress 網站(自架站)為例,首先,設定一下規則名稱,例如可以命名為「僅限從辦公室 IP 位址登入 WordPress」,設定一個讓你可以一眼看出來的名稱即可,重點在於第二個欄位,也就是設定要讓 Zone Lockdown 防護的網址,可以設定為:

  • *example.com/wp-login.php*
  • *example.com/wp-admin/*

請將上面的 example.com 替換成你的網域名稱,如果格式不同也自行調整一下。

在第三個欄位「IP Range」將你平常使用的固定 IP 設定進去,可使用 IP 區段或是 IPv6 位址,最後點選「Save and Deploy」就能保存並將設定啟用,一切都是這麼簡單。

STEP 4

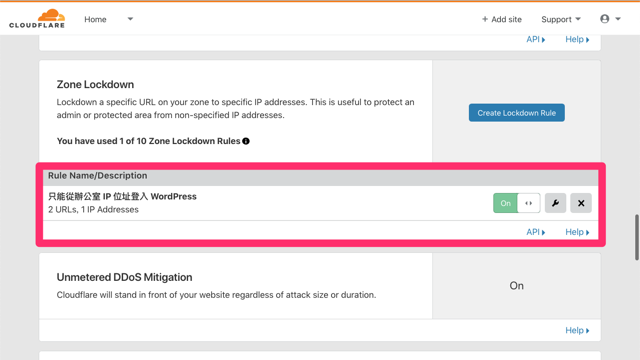
Cloudflare 各項模組功能都有快速開關,記得將規則切換到綠色的 On 才算啟用。

STEP 5

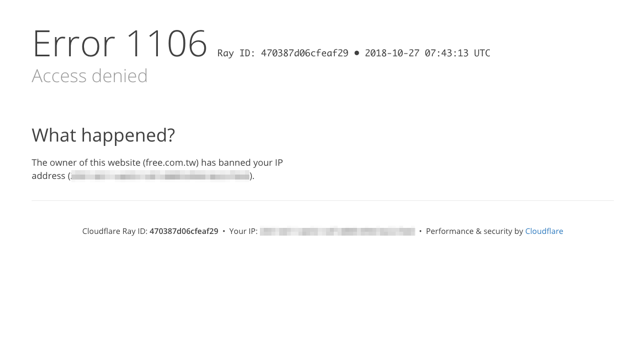
當有人連線到你設定防護的路徑,來源不在 IP 位址的白名單中,就會被 Zone Lockdown 模組自動擋掉,看到的會像下圖防火牆封鎖畫面(Access Denied)。

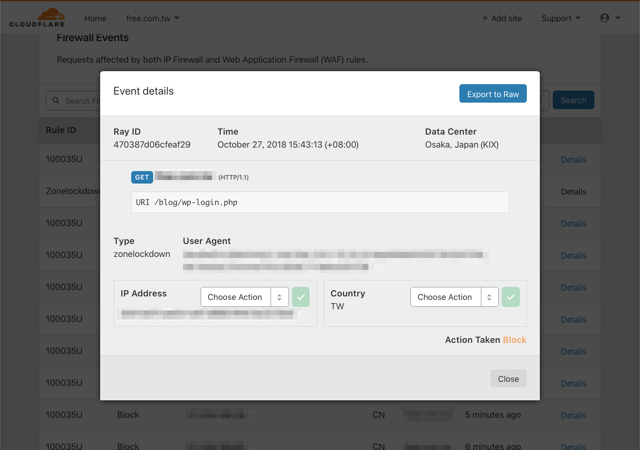
被阻擋的當下,Cloudflare 防火牆就會將此事件紀錄下來,可以在控制台看到被封鎖的來源、時間、存取的路徑、IP 位址及 User Agent 等資訊,當然如果是你不小心被阻擋,可以在 Firewall 中把自己加入白名單,就能解除問題,或者也可隨時將 Zone Lockdown 暫停或關閉。

本站聲明:網站內容來源免費資源網路社群https://free.com.tw,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

WP Test 測試 WordPress 最棒範例內容,填充各種內容協助開發佈景主題

每次建立一個全新 WordPress 網站進行測試前,總得先部署適合開發的環境,以往我都是使用 WordPress 官方提供的佈景主題開發測試範例元件(Theme Unit Test),能快速匯入一堆測試內容(也就是範例內容),這個範例檔其實藏得非常隱密,如果平常沒有閱讀說明文件的習慣可能很難馬上找到,後來我又陸續發現其他適用於 WordPress 的範例測試檔案,若你有開發上的需求,想要填充內容到新網站,可以試試看其他人準備好的檔案。

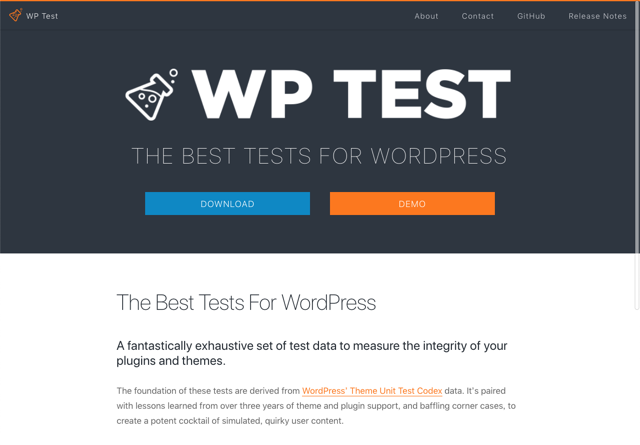
本文要介紹的「WP Test」從字面上的意思就知道是用於 WordPress 的測試資料,後來被新的擁有者收購成為 Post Status Labs Project ,WP Test 是一套非常詳盡、完整的測試檔案,可以作為開發外掛和佈景主題使用,它以 Theme Unit Test 為基礎,結合超過四年的課程經驗匯集而成的一個測試內容。

在 WP Test 中收錄各式的範例內容,包括各種文章、分類、標籤、媒體庫、頁面、迴響、選單和帳號等等,只要透過 WordPress 匯入工具匯入 .xml 檔即可快速建構出充滿各種測試內容的網站。值得一提的是 WP Test 開放原始碼,資料部分會隨著時間不斷更新,以符合各種版本階段的開發需求(不像 Theme Unit Test 可能很少更新),亦可透過 WP-CLI 指令列模式快速安裝測試內容。

網站名稱:WP Test
網站鏈結:http://wptest.io/

使用教學

STEP 1

首先,先從 WP Test 網站點選「Download」下載封裝好的測試檔,解壓縮後有一堆資料,我們只需要其中的 wptest.xml 檔案即可。

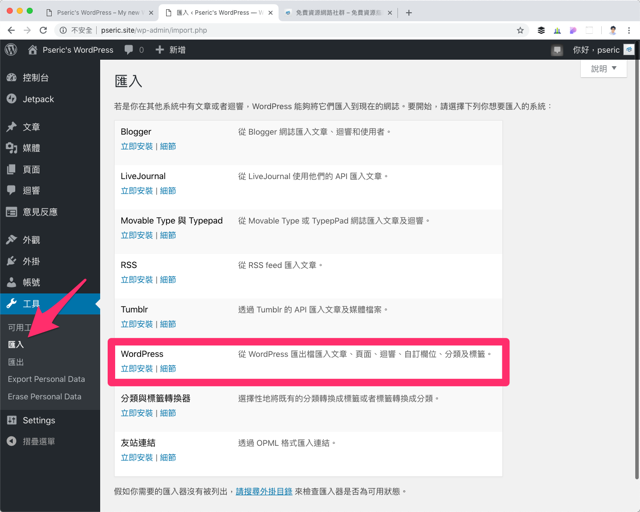
點選左側「工具」中的「匯入」,找到 WordPress 匯入器,點選「立即安裝」。

STEP 2

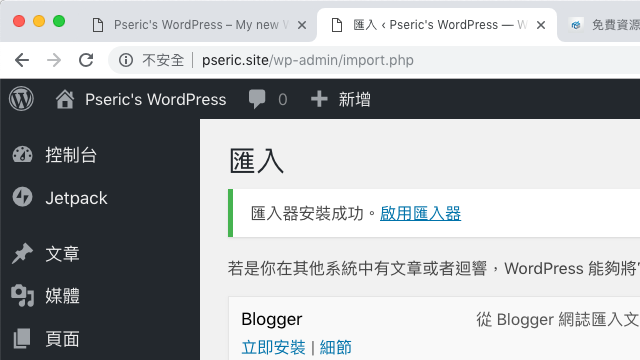
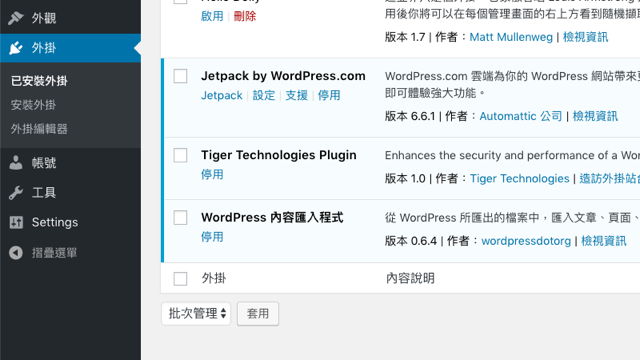
安裝好匯入器後,別忘記「啟用匯入器」,這功能最初內建於 WordPress,後來改以外掛方式下載安裝,使用後可以從外掛頁面將它停用、完整刪除。

STEP 3

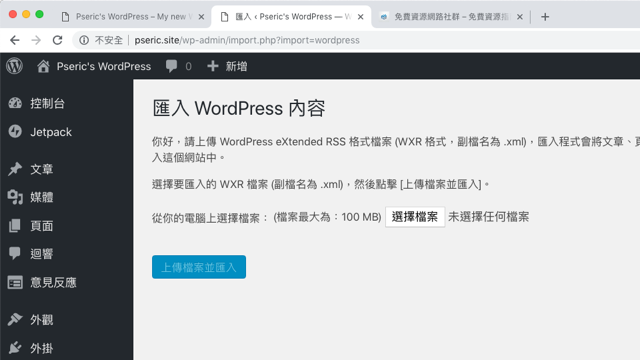
接著在 WordPress 內容的頁面中,點選「選擇檔案」然後找到剛才下載的 wptest.xml,選好後點選下方的藍色按鈕,會將文字部分內容匯入。

STEP 4

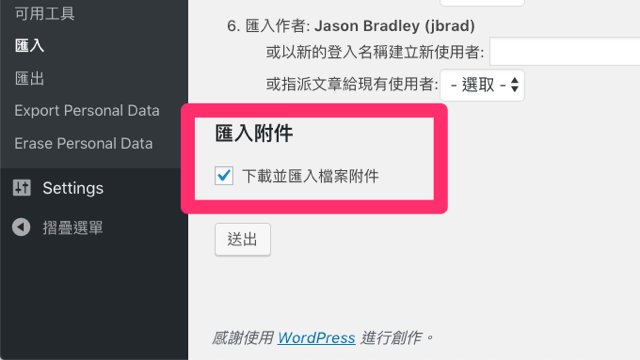
匯入作者頁面不要做任何更動,匯入前別忘記勾選「下載並匯入檔案附件」才不會讓某些圖片或媒體檔案無法看到,匯入時需要一段時間,請不要把分頁關閉,等待匯入工具跑完。

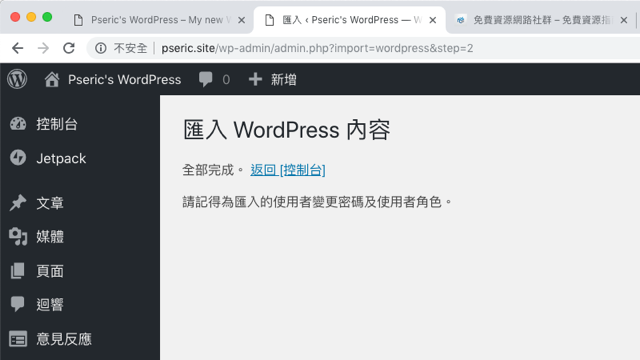
出現全部完成的提示訊息後就能返回控制台。

STEP 5

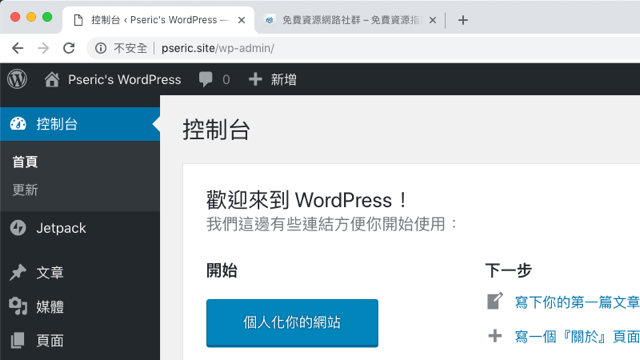
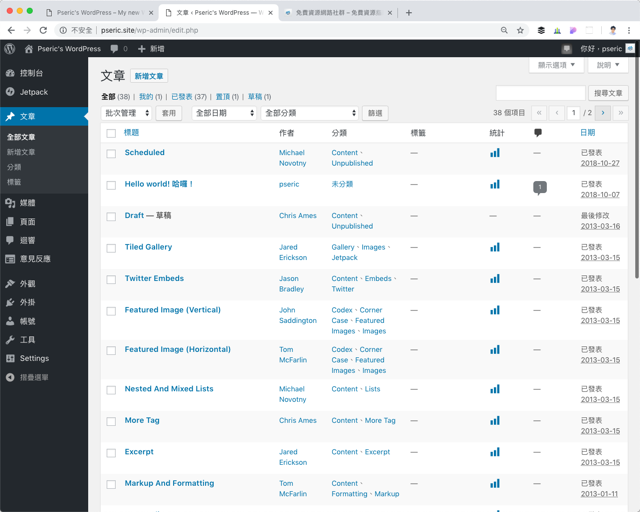
你會發現原有的 WordPress 多出很多文章,這些就是 WP Test 提供的範例內容,可以測試各種文章、不同佈景主題樣式的呈現效果,包括橫式和直立圖片、藝廊、Twitter、特色文章和摘要等等。

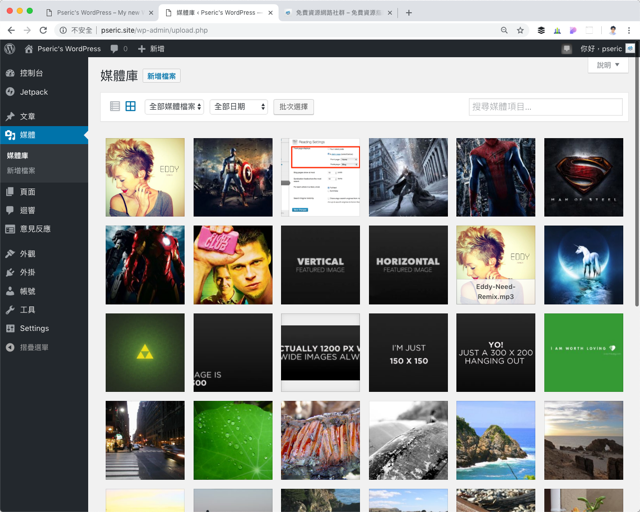
媒體庫裡也會匯入許多圖片,用以開發測試版面設計。

STEP 6

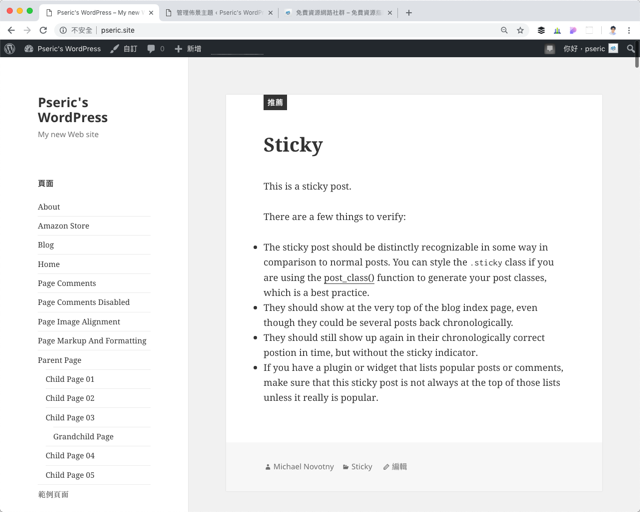
回到 WordPress 前台,這些預設好的內容就會依照你的佈景主題設計而變得不同,比較特別的是在 WP Test 也有提供測試用的選單,包括長選單及空白選單,如果你想在 WordPress 開發佈景主題或外掛,可能會需要填充一些內容進去測試,那麼 WP Test 就會很有用,可惜這些內容仍是以英文為主。

因為已經用不到了,匯入後別忘記到「外掛」功能中把 WordPress 內容匯入程式停用、刪除,這就是最簡單最基本的 WP Test 使用方法。

本站聲明:網站內容來源免費資源網路社群https://free.com.tw,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

自行創業 缺乏曝光? 下一步”網站設計“幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包”嚨底家”

如何退訂免費資源網路社群每日新文章 Email 電子報通知?

長久以來免費資源網路社群都有提供 Email 訂閱更新通知的功能,最早是使用 Google 的 FeedBurner RSS Feed 訂閱工具,後來選擇 Jetpack 的 Subscriptions 模組讓使用者能有更彈性運用,亦可選擇要接收的電子郵件格式和寄送時間(就是網站目前右上角的訂閱功能),對我來說,以 Email 接收資訊的管道是很必要的,在發佈文章後可以快速推送給使用者,相較於推送桌面通知我更傾向不打擾不干擾的 Email 郵件通知。


一般而言,有禮貌的 Email 電子報或訂閱郵件都會提供退訂鏈結(Unsubscribe),可以快速從郵件清單將自己的地址移除,通常都是一鍵完成,然而有些退訂方式就設計得比較難懂,還得手動選擇要退訂的訂閱項目或是反覆輸入 Email 地址,就更不用說是完全沒有提供退訂鏈結的電子報,這在台灣相當常見,不但相當冒犯也算是過時的方法。

偶爾會收到讀者來信詢問要如何停止接收免費資源網路社群的新文章通知?站在網站管理者的立場還是希望大家多多使用這項功能,不過如果真的覺得每天 Email 多到爆炸,而且沒有太多時間看文章的話,其實網站郵件通知是可以快速取消訂閱的。以下我會教大家怎麼樣管理訂閱或是退訂網站的 Email 通知。

如何退訂不想接收的電子報或郵件通知?

STEP 1

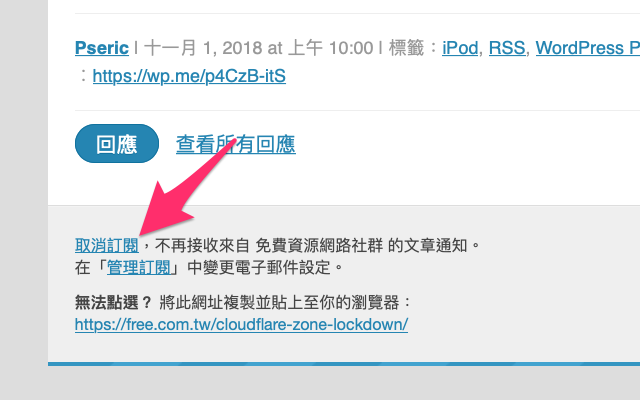
首先,打開你要退訂的郵件,在最下方可以找到「取消訂閱」和「管理訂閱」鏈結,不管點那一個鏈結都會連到 https://subscribe.wordpress.com/,這是 WordPress 提供的郵件通知功能,自然就是回到 WordPress 設定。

其他的 Email 電子報或行銷廣告也是類似的退訂方式,在郵件上方或下方通常能找到一個「Unsubscribe」,點選後就會引導到訂閱設定頁面,大多情況不用進行任何操作,就會自動將你從寄件名單刪除。

STEP 2

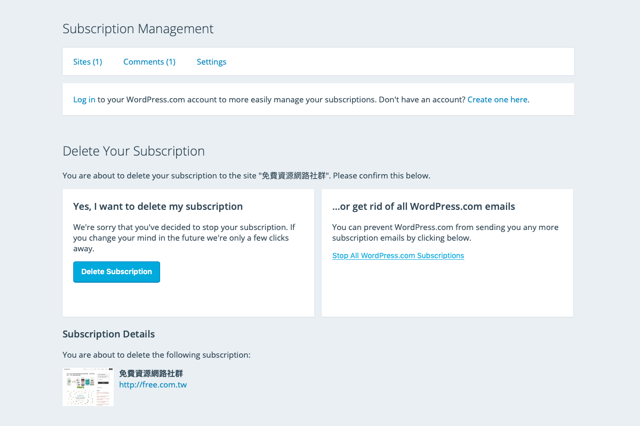
點選取消訂閱後,會引導到 WordPress 提供的訂閱管理頁面,不過目前還沒有完成中文化可能會有一些中英文字串夾雜的情形,在這裡可以看到你曾訂閱過的網站(例如免費資源網路社群),如果你不想完全退訂,但又希望能選擇接收郵件的時間,點選「Settings」鏈結調整要接收的 Email 格式和時間區間。

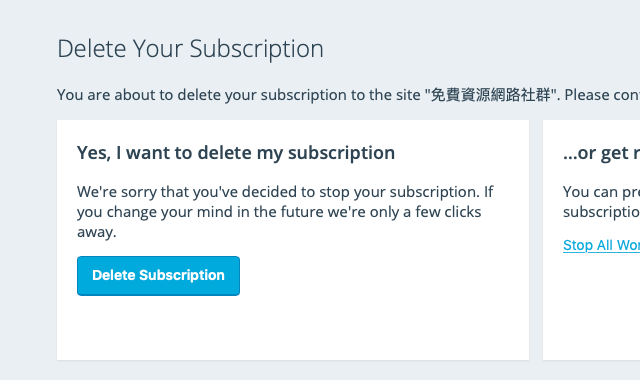
確定要刪除訂閱嗎?點一下中間的藍色按鈕「Delete Subscription」就能將你從寄件清單移除,沒關係,未來隨時可以重新訂閱,如果你已經訂閱很多來自 WordPress 網站的郵件通知,想要一次全部停掉,可點選右邊的「Stop All WordPress.com Subscriptions」鏈結,停止接收所有來自 WordPress.com 的訂閱郵件。

STEP 3

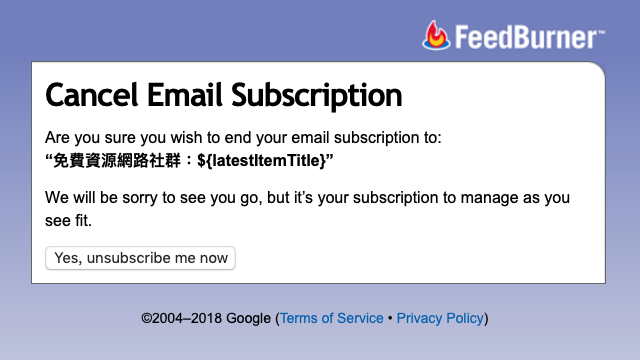
若你是更早期透過 FeedBurner 訂閱的朋友一樣也能手動退訂,不過可能日後就無法再次加入接收名單,因為網站目前已經沒有提供 FeedBurner 訂閱表單,但目前的訂閱功能仍可以隨時退訂或加入清單,退訂方法一樣是找到郵件最底下的 Unsubscribe,點選後進入看到如下頁面,再次點選確定訂閱的按鈕就能離開寄件名單。

STEP 4

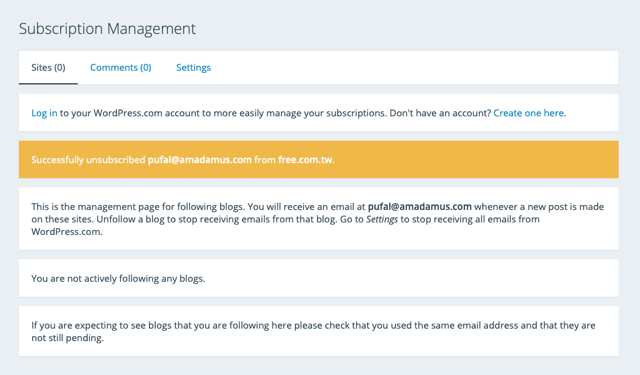
跳出黃色的 Successfully unsubscribed… 訊息後代表已成功取消訂閱。

本站聲明:網站內容來源免費資源網路社群https://free.com.tw,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!